http服务器工作原理 - http服务器工作原理图
-
http,服务器,工作,原理,图,想象,一下,你,轻轻,

- 建站百科知识-小虎建站百科知识网
- 2026-10-28 01:31
- 小虎建站百科知识网
http服务器工作原理 - http服务器工作原理图 ,对于想了解建站百科知识的朋友们来说,http服务器工作原理 - http服务器工作原理图是一个非常想了解的问题,下面小编就带领大家看看这个问题。
想象一下,你轻轻点击一个链接,瞬间,远在千里之外的服务器便开始了一场精密的数据交响乐。这背后,正是HTTP服务器工作原理在默默驱动。它如同一座数字世界的邮局,一套精密运转的传送带系统,一张清晰勾勒信息流转路径的工作原理图。本文将带你深入这座“邮局”内部,揭开从你按下回车键到网页完美呈现的神秘面纱,通过剖析核心工作机制图,让你真正理解万维网的基石是如何工作的。
核心架构:监听与端口守卫
HTTP服务器的旅程始于“倾听”。它并非被动等待,而是像一位警觉的哨兵,持续监听着特定的网络端口(通常是80或443)。你可以将这个端口理解为服务器这座大厦的专用门牌号。当服务器程序启动,它便绑定到这个端口,并进入一个循环:等待连接、处理请求、发送响应、关闭连接,周而复始。
这背后的工作原理图中,监听环节是起点。服务器通过操作系统提供的套接字(Socket)接口,创建一个监听套接字,并将其与IP地址和端口号绑定。这个过程,就像为信息洪流开辟了一条专属河道。它不处理具体业务,只负责接收一切试图通过这扇“门”的访问请求。
没有这个坚实的监听基础,后续的所有复杂处理都无从谈起。它是服务器与广阔互联网世界建立联系的唯一桥梁,确保了数据包能够被准确识别和接收,为后续的深度对话铺平道路。
请求接收:解析信息的艺术
当客户端(如浏览器)的请求跋山涉水抵达服务器端口,真正的魔术开始了。服务器接受TCP连接后,便收到了原始的HTTP请求报文。这报文并非立即可读的明文,而是一串遵循严格格式的字节流。
服务器启动解析引擎。它首先要做的是解析请求行,识别出关键的HTTP方法(GET、POST等)、目标URL以及HTTP协议版本。紧接着,它会逐行解析请求头部,这些头部携带了关于客户端、所需内容、缓存策略等海量元数据。如果是POST等带有实体的请求,它还会解析消息体。
在工作原理图上,这是一个关键的“解码”环节。服务器如同一位精通多国语言的翻译官,将网络传输的原始字节,转换为自己能够理解的内部数据结构。任何解析错误都可能导致请求失败,返回著名的“400 Bad Request”错误。这个过程的高效与准确,直接决定了服务器对用户意图的理解深度。
请求路由与资源定位
理解用户“要什么”之后,服务器需要找到“东西在哪”。这就是请求路由与资源定位。解析出的URL路径,会被映射到服务器文件系统上的一个具体位置,或者传递给后端的应用程序(如PHP、Python程序)。
对于静态资源(如图片、CSS、HTML文件),服务器通常根据配置的文档根目录,将URL路径转换为文件路径。例如,请求“/images/logo.png”,可能对应到服务器磁盘的“/var/www/html/images/logo.png”。这个过程在工作原理图中体现为一次关键的路径查找与映射。
对于动态资源,URL可能被路由到特定的应用处理程序。服务器(如Apache的mod_php,Nginx的FastCGI配置)充当了一个调度员,将请求和必要的参数传递给后端应用,并等待其处理结果。这一步是静态服务与动态网页的分水岭,是服务器智能化服务的基础。
业务处理与响应生成
找到目标后,便进入核心的业务处理阶段。对于静态文件,服务器只需读取文件内容。对于动态请求,后端应用程序开始大显身手:查询数据库、执行逻辑运算、渲染模板。这个过程可能会耗费相当的计算资源和时间。
处理完毕后,服务器需要构建HTTP响应。响应同样有严格的格式:状态行(如“HTTP/1.1 200 OK”)、响应头部(包含内容类型、长度、服务器信息、缓存控制等),以及最重要的响应正文(即用户最终看到的HTML、图片数据等)。
在工作原理图中,这是从“理解”到“创造”的转变。服务器从一个被动的信息索取对象,转变为主动的内容创造者和组织者。它根据请求的上下文,生成一个包含状态、描述和实际内容的完整“包裹”,准备发回给望眼欲穿的客户端。
响应发送与连接管理
生成好的响应报文,将通过建立的TCP连接通道,被拆分成多个TCP数据包发送回客户端。这里涉及复杂的网络传输控制。服务器需要高效地管理输出缓冲区,确保数据有序、可靠地送达。
连接管理策略是这一环节的智慧所在。早期的HTTP/1.0默认为每个请求/响应关闭连接,效率低下。现代的HTTP/1.1默认使用持久连接,允许在同一连接上传输多个请求和响应,大大减少了开销。而HTTP/2更是引入了多路复用,让多个请求交织在一起,效率飞跃。
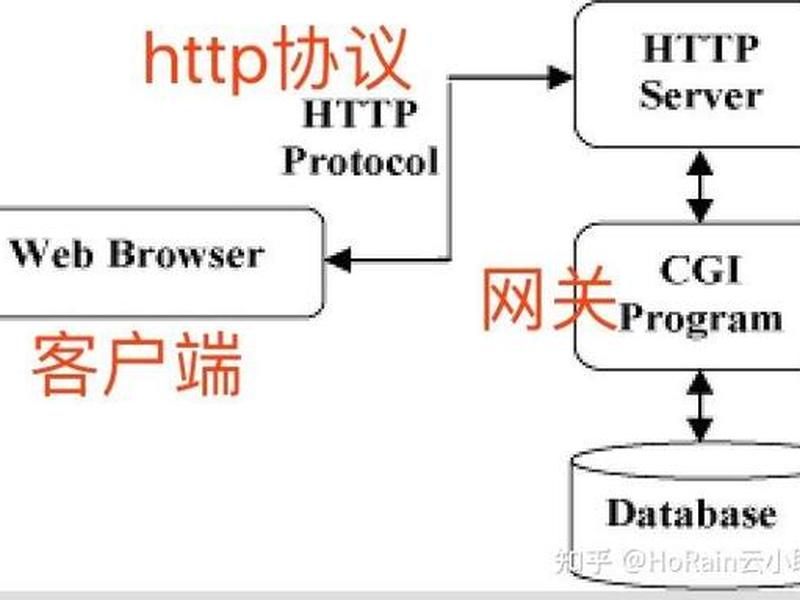
在工作原理图的末端,这代表着一次服务周期的完成。服务器需要考虑是否立即关闭连接,还是保持连接以供后续请求使用。这个决策影响着服务器的并发能力和资源利用率,是应对海量访问的关键优化点。
并发模型:应对洪流的引擎
一个服务器在同一时刻要面对成千上万的请求,如何做到并行不悖?这依赖于其并发处理模型。经典的多进程模型(如Apache prefork)为每个连接创建一个进程,稳定但资源消耗大。多线程模型在一个进程内创建多个线程处理连接,更轻量。
事件驱动模型(如Nginx、Node.js)则采用了颠覆性的思路:使用单线程(或少量线程)配合非阻塞I/O和事件循环。当线程需要等待I/O(如读取文件、查询数据库)时,它不会阻塞,而是去处理其他已就绪的事件。这在工作原理图上表现为一个高效的中心调度器,用极少的资源承载极高的并发。
选择哪种模型,决定了服务器的性能天花板和资源消耗曲线。它是HTTP服务器工作原理中最具工程美感的部分,是软件架构师们为应对互联网流量洪流而设计的精巧解决方案。
以上是关于http服务器工作原理 - http服务器工作原理图的介绍,希望对想了解建站百科知识的朋友们有所帮助。
本文标题:http服务器工作原理 - http服务器工作原理图;本文链接:https://zwz66.cn/jianz/391917.html。
猜你喜欢
- Http服务器怎么设置;http服务器怎么设置 2026-10-28
- http服务器地址、服务器地址https 2026-10-28
- http服务器和应用服务器、http服务器和应用服务器的关系 2026-10-28
- http服务器和www服务器、http服务和web服务 2026-10-28
- http服务器原理;http服务器配置 2026-10-28
- HTTP服务器主要用于什么场景、http服务器主要用于什么场景 2026-10-28
- http服务器与web服务器 http服务器和web服务器 2026-10-28
- http服务器 web服务器、http服务器与web服务器 2026-10-28
- http和webserver(http和webserver请求的区别) 2026-10-28
- http可以打开https打不开 浏览器打不开https的网页 2026-10-28







