网络监控服务器搭建(网络监控服务器搭建方案)
-
网络监控,服务器,搭建,方案,在,数字,洪流,

- 建站百科知识-小虎建站百科知识网
- 2026-10-10 23:16
- 小虎建站百科知识网
网络监控服务器搭建(网络监控服务器搭建方案) ,对于想了解建站百科知识的朋友们来说,网络监控服务器搭建(网络监控服务器搭建方案)是一个非常想了解的问题,下面小编就带领大家看看这个问题。
在数字洪流奔涌的时代,企业网络如同城市的血管,一旦堵塞或遭遇入侵,带来的将是业务停滞与数据泄露的致命危机。你是否曾对网络中的异常流量感到茫然无措?是否担忧关键业务在夜深人静时悄然宕机?网络监控服务器,正是照亮网络暗区、构筑主动防御体系的“安全之眼”。本文将为你揭开高效、稳定网络监控服务器搭建的神秘面纱,提供一套从蓝图规划到实战部署的完整方案,助你牢牢掌控网络命脉,让潜在威胁无所遁形。
一、 蓝图规划:奠定成功的基石
任何伟大的工程都始于一张清晰的蓝图,网络监控服务器的搭建也不例外。这一阶段的核心在于“谋定而后动”,避免因盲目部署导致的资源浪费与架构缺陷。
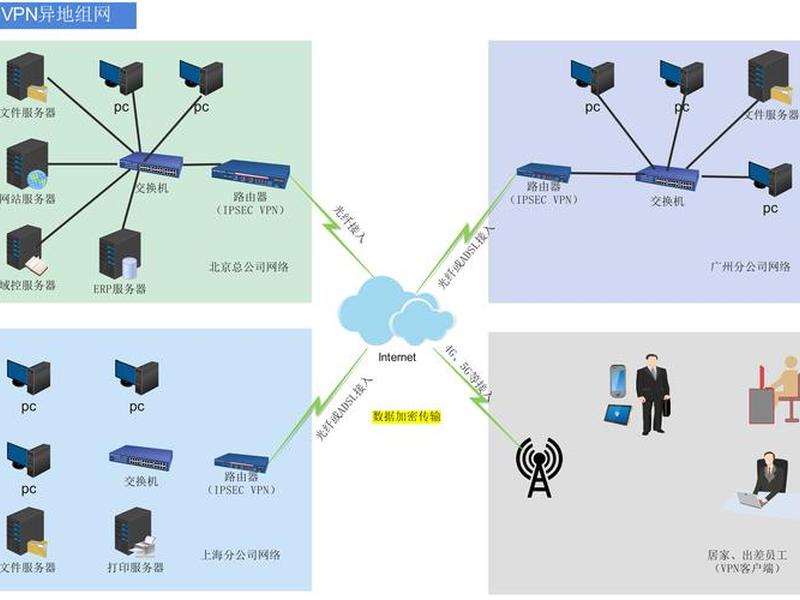
必须进行彻底的需求探矿。你需要明确监控的边界:是覆盖整个企业内网,还是聚焦于核心数据中心?需要监控的对象包括服务器、网络设备(交换机、路由器)、安全设备还是应用程序?确定关键数据流,例如数据库访问、对外服务接口流量等,这些是监控的重中之重。不同的目标决定了后续工具选型与资源投入的规模。
进入工具选型竞技场。市面上主流监控工具各具特色:Zabbix以其强大的自定义能力和分布式监控见长,适合复杂、大规模环境;Prometheus与云原生和容器化环境天生契合,擅长指标采集与告警;Nagios则以其稳定性和丰富的插件生态闻名。选择时需权衡功能、学习成本、社区支持与企业技术栈的契合度。切忌追求功能大而全,适合的才是最好的。
进行硬件资源沙盘推演。监控服务器的性能直接决定其能承载的监控体量与响应速度。你需要评估监控项的数量、数据采集频率以及历史数据的保留周期。CPU核心数、内存容量、磁盘I/O性能与存储空间是关键考量点。一个粗略的经验法则是:每1000个监控项,建议预留至少2核CPU、4GB内存;存储空间则需根据数据保留策略(如保留30天详细数据)和每日数据增量来精细计算。
二、 环境构筑:打造稳固的作战平台
当蓝图绘制完毕,下一步便是构筑坚实可靠的运行环境。这个阶段如同为精密仪器搭建无尘车间,任何细微的疏漏都可能在未来引发连锁故障。
操作系统的抉择是首要战场。Linux发行版,如CentOS Stream、Rocky Linux或Ubuntu Server,因其高稳定性、卓越性能与丰富的开源软件生态,成为绝大多数监控服务器的首选。它们对资源开销更小,命令行操作提供了强大的自动化可能。如果企业内部技术栈深度绑定Windows,Windows Server也是一个可选方案,只是需要注意其对特定监控软件的支持度与潜在的授权成本。
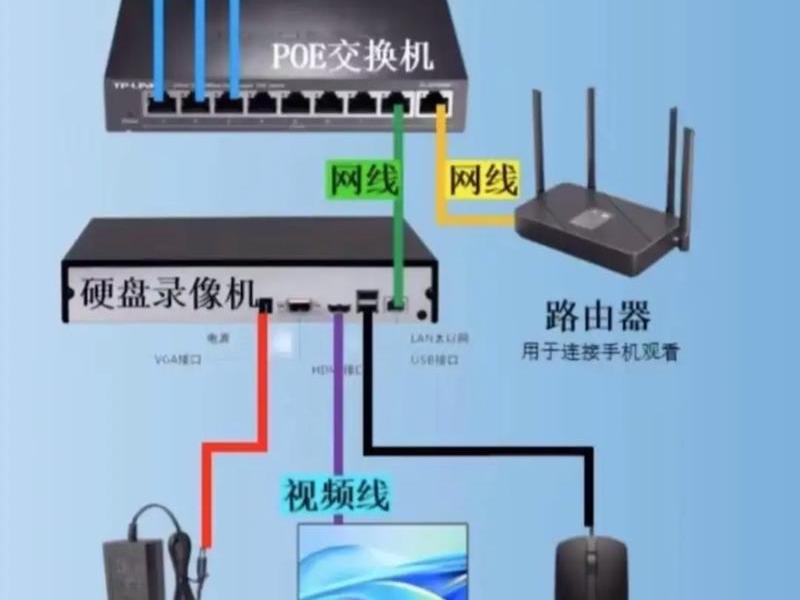
紧接着是网络环境的精细调校。为监控服务器配置一个静态IP地址是必须的,这确保了其地址的永恒不变,方便所有被监控设备准确寻址。防火墙规则的配置需要遵循最小权限原则:仅开放监控软件必需的端口(如Zabbix的10051端口),并对管理访问(如SSH或远程桌面)实施严格的IP白名单限制。确保监控服务器与被监控设备之间的网络路由畅通,延迟与丢包率在可接受范围内,是数据准确采集的前提。
完成基础环境配置后,便进入监控软件的安装与初启环节。务必遵循官方文档或权威社区指南。以在CentOS上安装Zabbix为例,过程通常包括配置软件仓库、安装服务器端、前端及数据库(如MySQL/MariaDB或PostgreSQL)组件,并进行初始的数据库配置与Web界面安装。安装完成后,通过Web界面完成初始登录与基本配置,一个监控系统的雏形便宣告诞生。
三、 数据采集:编织无处不在的感知网络
监控服务器的核心价值在于数据,而数据采集则是其感知世界的“神经末梢”。这一阶段的目标是让监控触角延伸到每一个需要关注的角落。
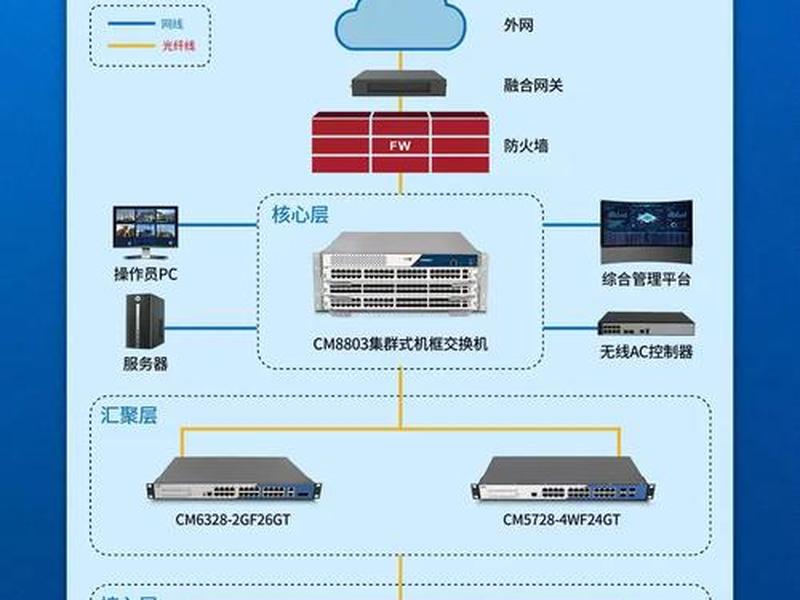
部署数据采集点是实现全面感知的关键。对于网络流量监控,可以在核心交换机上配置端口镜像(SPAN),将流量复制一份发送给监控服务器进行分析。对于服务器与应用监控,则需要在被监控目标上安装对应的代理(Agent),如Zabbix Agent或Prometheus Exporter。这些代理如同忠诚的哨兵,定期收集本地系统指标(CPU、内存、磁盘)或应用特定指标,并上报给监控服务器。对于不支持代理的设备(如网络打印机、老旧设备),则可以通过SNMP协议进行抓取。
接下来是定义监控规则与指标阈值。这是将原始数据转化为 actionable insight(可操作的洞察)的核心步骤。你需要为每个监控项定义合理的监控间隔(如30秒采集一次CPU使用率)和触发器(Trigger)条件。例如,当某台Web服务器的CPU使用率连续5分钟超过90%,或者某关键端口的响应时间超过200毫秒时,便触发警报。阈值的设置需要结合历史基线数据与业务容忍度,设置得过低会导致警报泛滥(狼来了效应),过高则会错过早期预警时机。
利用监控软件强大的数据分析与可视化能力,将冰冷的数字转化为直观的图表。通过创建仪表盘(Dashboard),你可以将核心业务指标、基础设施健康状态集中展示。趋势图能揭示性能的缓慢劣化,拓扑图可以展示设备间的依赖关系。良好的可视化不仅能提升监控效率,更能为容量规划与故障回溯提供有力依据。
四、 告警响应:构建敏捷的防御闭环
一个只会收集数据却无法及时告警的监控系统,无异于没有警报器的保险库。建立高效、智能的告警与响应机制,是让监控系统“活”起来的关键。
告警通知渠道的多元化配置是第一步。确保警报能以多种方式抵达运维人员:电子邮件适用于非紧急通知;即时通讯工具(如钉钉、企业微信、Slack)的Webhook集成可以实现快速群告警;短信和电话语音则用于最高优先级的紧急事件,确保在无人值守时也能被及时感知。关键在于根据警报的严重等级(如信息、警告、严重、灾难)匹配不同的通知渠道和升级策略。
随后,必须制定清晰的应急响应预案。警报响起后应该做什么?一个标准的流程可能包括:确认警报真实性(是否为误报)、初步定位问题影响范围、根据预案执行紧急操作(如重启服务、切换流量)、进行根本原因分析并修复。将常见故障的排查步骤和命令固化到预案或自动化脚本中,能极大缩短平均恢复时间(MTTR)。
引入告警收敛与降噪机制至关重要。在大型故障中,往往一个根因会引发海量关联警报。通过设置事件关联规则、告警依赖关系或使用监控软件的告警压缩功能,可以将数百条警报合并为一条根源事件通知,避免告警风暴淹没运维团队,使其能聚焦于真正的问题核心。
五、 运维优化:实现系统的永续精进
监控系统的搭建并非一劳永逸,持续的维护与优化是其保持长期有效性的生命线。这是一个追求卓越、不断演进的过程。
定期的软件更新与安全加固是基础防线。及时为监控服务器的操作系统、数据库及监控软件本身打上安全补丁,堵住已知漏洞。定期审计用户账户权限,确保遵循最小权限原则;检查并清理不必要的服务与开放端口;对监控数据本身(特别是包含配置信息的数据库)进行加密与访问控制,防止监控系统本身成为安全短板。
建立可靠的备份与恢复策略是应对灾难的保险绳。监控配置信息(如主机清单、监控项、触发器、仪表盘)的丢失可能导致数日的重建工作。应定期备份监控软件的配置文件与数据库,并测试恢复流程的有效性。对于重要的历史监控数据,也应考虑其归档策略,以满足合规性审计或长期趋势分析的需求。
持续的性能调优与容量规划让系统历久弥新。随着监控规模的扩大,需要关注监控服务器的负载情况:数据库查询是否变慢?前端界面响应是否延迟?根据监控数据自身的增长趋势,提前规划硬件扩容或进行数据库索引优化、数据分区(如按时间分区)等操作。定期审视监控项的有效性,禁用或调整那些不再需要或从未触发过的监控项,让系统保持轻盈与高效。
六、 进阶实战:应对复杂场景的挑战
当基础监控体系稳固后,可以探索更高级的部署模式以满足复杂需求。分布式监控架构是应对超大规模环境的核心武器。通过设立多个监控节点(Proxy或Satellite)进行区域数据采集和预处理,再由中心服务器进行数据聚合与统一展示,可以有效分担中心压力,并提升跨地域监控的可靠性。
对于云原生与混合云环境的监控,需要采用新的思路。除了监控虚拟机或容器的基础设施指标,更要关注服务发现、动态伸缩、微服务链路追踪等。Prometheus Operator、Service Mesh集成等现代化方案能更好地适应这种动态、瞬态的环境。
将监控与自动化运维(AIOps)流程对接是未来的方向。例如,当监控系统检测到磁盘空间不足时,可以自动触发清理脚本;或当业务流量激增时,自动联动云平台进行弹性扩容。这种闭环自动化能极大提升运维效率与系统韧性。
以上是关于网络监控服务器搭建(网络监控服务器搭建方案)的介绍,希望对想了解建站百科知识的朋友们有所帮助。
本文标题:网络监控服务器搭建(网络监控服务器搭建方案);本文链接:https://zwz66.cn/jianz/375980.html。
猜你喜欢
- 网络环境搭建教程(网络环境搭建教程视频) 2026-10-10
- 网络源码建站教程视频 源码搭建网站流程 2026-10-10
- 网络源码建站教程图片;网站源码搭建教程 2026-10-10
- 网络服务器搭建配置与管理、网络服务器搭建配置与管理方案 2026-10-10
- 网络数据库搭建详细教程,网络数据库搭建详细教程pdf 2026-10-10
- 网络搭建项目实战 - 网络搭建项目实例 2026-10-10
- 网络搭建视频教程 网络搭建视频教程全集 2026-10-10
- 网络搭建程序开发学习资料 总结网络搭建流程 2026-10-10
- 网络搭建的最佳方案 网络搭建的最佳方案有哪些 2026-10-10
- 网络搭建的基本流程、网络搭建的基本流程包括 2026-10-10







