数据库创建表教程 数据库创建表教程详解
-
数据库,创建,表,教程,详解,在,数据,驱动,的,

- 建站百科知识-小虎建站百科知识网
- 2026-10-02 11:45
- 小虎建站百科知识网
数据库创建表教程 数据库创建表教程详解 ,对于想了解建站百科知识的朋友们来说,数据库创建表教程 数据库创建表教程详解是一个非常想了解的问题,下面小编就带领大家看看这个问题。
在数据驱动的时代,数据库如同数字世界的基石,而数据表则是构成这座大厦的砖石。无论你是初涉数据库领域的新手,还是希望夯实基础的开发者,掌握创建数据表的精髓,都意味着你拿到了开启数据宝库的第一把钥匙。数据表不仅仅是存储数据的容器,更是数据关系、业务逻辑与运行效率的具象化体现。一个设计精良的表结构,能为应用提供稳定高效的支撑;反之,则可能成为系统性能的瓶颈与维护的噩梦。本文将带你深入探索数据库创建表的完整世界,从核心概念到实战技巧,为你铺就一条从入门到精通的清晰路径。
理解表的本质与核心概念
数据表是关系型数据库中最基本的存储单元,其本质是一个二维结构,由行和列组成。每一行代表一条独立的记录,每一列则定义了记录中某个特定属性的类型与约束。想象一下一张Excel表格,横向是记录,纵向是字段,数据库表正是这一结构的规范化与强化版本。
创建表的过程,远不止是定义几个字段那么简单。它是对未来将要存储的数据进行的一次至关重要的“立法”。你需要为每个字段选择合适的数据类型,这决定了数据如何被存储与解释,比如用整数存储年龄,用字符串存储姓名,用日期类型存储生日。约束条件如同法律条文,保障数据的质量与一致性,例如设置主键来唯一标识每行记录,使用非空约束确保关键信息不被遗漏。
更深层次地,表的设计直接关联着数据库的三大完整性:实体完整性、参照完整性和域完整性。通过主键、外键、检查约束等手段,确保数据是准确、有效且相互关联的。在动笔编写CREATE TABLE语句之前,花时间进行严谨的数据建模与业务分析,是避免后续无尽麻烦的关键一步。
掌握创建表的核心语法结构
创建数据表的核心命令是SQL中的CREATE TABLE语句。其基本语法骨架清晰而强大,允许开发者定义表名、字段名、数据类型及各类约束。一个典型的创建语句包含以下部分:以CREATE TABLE关键字开头,后接表名,括号内则是用逗号分隔的列定义列表。
每个列的定义包含列名和数据类型,这是最基础的组成部分。数据类型的选择范围广泛,从精确的数字类型如INT、DECIMAL,到可变的字符类型如VARCHAR、CHAR,再到专门处理时间的DATE、DATETIME等。选择恰当的类型不仅能节省存储空间,更能提升查询效率。
在列定义之后,还可以在表级添加额外的约束,例如定义复合主键、外键关系等。现代数据库管理系统还允许指定表的存储引擎、默认字符集和排序规则。例如,在MySQL中,可以指定ENGINE=InnoDB以获得事务支持,指定CHARSET=utf8mb4以完美存储包括表情符号在内的所有Unicode字符。理解并熟练运用这些语法选项,是创建出高性能、高可维护性数据表的基础。
精雕细琢:字段类型与约束设计
字段类型的选择是一门平衡的艺术。数值类型中,TINYINT、SMALLINT、INT、BIGINT分别对应不同范围的整数,选择过大会浪费空间,选择过小则可能导致数据溢出。对于需要精确计算的金额,DECIMAL类型是比FLOAT或DOUBLE更可靠的选择。字符串类型中,VARCHAR(n)适用于长度可变的文本,而CHAR(n)则适用于长度固定的内容,查询速度更快。
约束是数据质量的守护神。PRIMARY KEY约束定义了表的主键,确保每行数据的唯一性,并且通常与AUTO_INCREMENT属性结合,实现自动递增。NOT NULL约束强制字段必须包含值,不允许为空。UNIQUE约束保证列中所有值各不相同。CHECK约束允许定义更复杂的条件来验证数据。FOREIGN KEY约束则在表与表之间建立关联,维护参照完整性。
合理运用这些约束,能从根本上杜绝脏数据的产生。例如,在用户表中,可以将用户ID设为主键并自增,用户名设置为唯一且非空,邮箱地址也设置为唯一,并将状态字段通过CHECK约束限定为几个固定的有效值。这样的设计使得数据在入库时即经过严格校验,为后续的数据处理与分析打下了坚实基础。
实战演练:从设计到创建完整流程
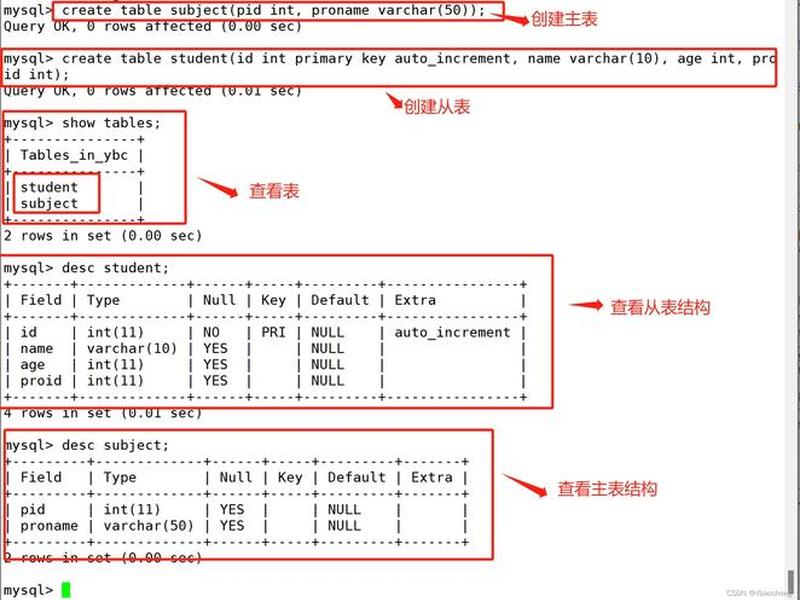
理论需要结合实践才能真正掌握。假设我们需要为一个简单的博客系统创建文章表。首先进行设计思考:一篇文章需要唯一ID、标题、内容摘要、正文、作者ID、所属分类ID、发布时间、最后修改时间以及状态等属性。
基于此设计,我们可以编写如下SQL语句(以MySQL为例):
```
CREATE TABLE `articles` (
`id` BIGINT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT ‘文章唯一ID’,
`title` VARCHAR(200) NOT NULL COMMENT ‘文章标题’,
`summary` VARCHAR(500) DEFAULT NULL COMMENT ‘内容摘要’,
`content` TEXT NOT NULL COMMENT ‘文章正文’,
`author_id` INT NOT NULL COMMENT ‘作者ID’,
`category_id` INT NOT NULL COMMENT ‘分类ID’,
`publish_time` DATETIME DEFAULT CURRENT_TIMESTAMP COMMENT ‘发布时间’,
`update_time` DATETIME DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP COMMENT ‘最后修改时间’,
`status` TINYINT NOT NULL DEFAULT ‘1’ COMMENT ‘状态:1-草稿,2-已发布,3-已删除’,
PRIMARY KEY (`id`),
KEY `idx_author_id` (`author_id`),
KEY `idx_category_id` (`category_id`),
KEY `idx_publish_time` (`publish_time`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci COMMENT=‘文章表’;
```
这个例子涵盖了自增主键、多种数据类型、默认值、注释、索引以及存储引擎和字符集的指定,是一个比较完整的生产表示例。
高级技巧与最佳实践指南
在掌握了基础创建方法后,一些高级技巧和最佳实践能让你设计的表更具专业水准。命名规范至关重要。表名和字段名应使用有意义的英文单词或下划线连接,保持统一风格。为每个字段和表添加清晰的COMMENT注释,这在团队协作和后期维护时价值连城。
索引是提升查询性能的利器,但需要在创建表时或之后慎重添加。通常对作为查询条件的字段(如外键、状态字段、时间字段)创建索引。但索引并非越多越好,因为它会增加数据插入和更新的开销。另一个重要实践是合理规划存储引擎。InnoDB引擎支持事务和行级锁,适用于绝大多数需要数据一致性和并发读写的在线业务场景。
考虑数据生命周期,可以为表设计分区,将历史数据与热数据分离,提升管理效率。在云数据库时代,还需注意一些云厂商的特定优化选项。遵循这些最佳实践,能够确保你的数据表不仅在功能上正确,更在性能、可扩展性和可维护性上达到生产级标准。
避坑指南与常见问题解析
初学者在创建表时常会踏入一些陷阱。一个常见错误是过度使用VARCHAR(MAX)或TEXT等大字段类型,这会影响查询性能并使表优化变得困难。应根据业务实际需求设定合理的长度限制。另一个陷阱是忽视字符集和排序规则,导致存储中文或其他多字节字符时出现乱码,统一使用utf8mb4是目前的推荐选择。
忘记设置主键或使用了可更新的字段作为主键,也是常见的设计缺陷。主键应保持稳定且唯一。盲目添加冗余字段以求“方便”,会破坏数据范式,增加数据不一致的风险。在生产环境直接执行DDL语句修改大表结构,可能导致数据库锁表,服务长时间不可用,此类操作应在低峰期进行或使用在线变更工具。
对于自增ID耗尽、时间字段时区处理、软删除设计等问题,也需要提前考量。通过理解这些常见问题及其背后的原理,并在设计之初就采取规避措施,可以极大减少上线后故障排查和紧急重构的压力。
以上是关于数据库创建表教程 数据库创建表教程详解的介绍,希望对想了解建站百科知识的朋友们有所帮助。
本文标题:数据库创建表教程 数据库创建表教程详解;本文链接:https://zwz66.cn/jianz/366611.html。
猜你喜欢
- 数据库建在哪一端,数据库一般建在哪里 2026-10-02
- 数据库创建失败是怎么回事、数据库创建失败怎么解决 2026-10-02
- 数据库创建和管理索引 - 数据库创建和管理索引的方法 2026-10-02
- 数据库创建与管理的实训总结;数据库创建与管理实验总结 2026-10-02
- 数据库创建与管理 数据库创建与管理实验报告 2026-10-02
- 数据库mysql建表新手使用教程;怎样用mysql建立数据库表格 2026-10-02
- 数据库 建设(数据库建设收费标准) 2026-10-02
- 搜狗百科如何创建;搜狗百科如何创建搜索引擎 2026-10-02
- 搜狗按步骤创建词库 - 搜狗按步骤创建词库怎么弄 2026-10-02
- 搜狗怎样创建自己的网站;搜狗怎样创建自己的网站链接 2026-10-02







