数据库创建和管理索引 - 数据库创建和管理索引的方法
-
数据库,创,建和,管理,索引,的,方法,在,浩瀚,

- 建站百科知识-小虎建站百科知识网
- 2026-10-02 11:42
- 小虎建站百科知识网
数据库创建和管理索引 - 数据库创建和管理索引的方法 ,对于想了解建站百科知识的朋友们来说,数据库创建和管理索引 - 数据库创建和管理索引的方法是一个非常想了解的问题,下面小编就带领大家看看这个问题。
在浩瀚的数据海洋中,数据库索引如同精准的航海图和强大的引擎,决定了信息检索的速度与效率。想象一下,在一座拥有千万册藏书的图书馆里,没有目录索引,寻找一本特定的书籍将是何等噩梦。数据库索引正是为了终结这种“数据迷失”而生的关键技术。它通过巧妙的“空间换时间”策略,将查询响应时间从令人沮丧的分钟级压缩至毫秒级,是现代应用流畅体验背后的无名英雄。本文将深入剖析数据库索引的创建与管理之道,为您揭示构建高性能数据系统的核心秘密。
索引的基石:类型与设计策略
数据库索引的世界并非只有一种面貌。理解不同类型的索引及其适用场景,是进行高效设计的第一步。最常见的索引类型包括聚集索引和非聚集索引。聚集索引决定了表中数据的物理存储顺序,一个表只能有一个,它就像图书馆按照书名首字母严格排序的书架。而非聚集索引则独立于数据存储,它更像是一个独立的目录册,可以创建多个,指向数据的物理位置。
索引设计是一项需要深思熟虑的艺术。首要任务是精准识别需要索引的列。通常,出现在WHERE子句、JOIN条件以及ORDER BY子句中的列是索引的候选者。例如,在电商平台的订单表中,用户ID、订单状态和创建时间经常作为查询条件,为这些列创建复合索引能极大提升查询性能。设计时需遵循“最左前缀原则”,即索引(A, B, C)可以优化对A、(A, B)或(A, B, C)的查询,但无法优化单独对B或C的查询。
另一个关键考量是索引的选择性。选择性高的列(即唯一值多、重复值少的列)更适合创建索引。例如,为“性别”这样只有两三个取值的列创建独立索引,其收益往往微乎其微,因为数据库优化器可能宁愿进行全表扫描。相反,像“身份证号”、“手机号”这类高选择性字段,则是索引的理想选择。设计时还需评估数据更新频率,因为每个索引都会在数据插入、更新和删除时带来额外的维护开销。
创建之道:方法与最佳实践
掌握了设计原则,下一步便是将蓝图变为现实。索引的创建主要有两种途径:通过约束隐式创建和使用CREATE INDEX语句显式创建。为表定义PRIMARY KEY(主键)或UNIQUE(唯一)约束时,数据库引擎会自动创建对应的唯一索引以确保数据完整性。这种方式简洁明了,索引名称也与约束名相同。
对于更复杂的场景,则需要使用CREATE INDEX语句进行显式创建。这允许开发者指定索引名称、关联的表和列,以及各种索引选项,如填充因子、排序规则,以及索引所在的文件组或分区方案。例如,可以为一个商品表的“商品名称”和“类别ID”创建一个非聚集的复合索引。对于文本搜索需求,还可以创建特殊的全文索引,它能对TEXT类型的字段进行自然语言分词与搜索,极大提升了内容检索的体验。
创建索引时,一个至关重要的决策点是选择在空表还是已有数据的表上操作。在空表上创建索引几乎没有性能影响,但随着数据不断写入,索引结构会动态调整。而对于已存在海量数据的表,创建索引则是一个需要谨慎安排的操作,它可能消耗大量I/O和CPU资源,并长时间锁表,影响线上服务。为此,许多数据库系统提供了“联机创建索引”选项,它允许在索引构建过程中,基础表依然可以接受查询和更新,这对于需要7x24小时运行的系统至关重要。
性能调优:让索引发挥极致效能
创建索引只是开始,持续的监控与调优才能确保其长期高效运行。首要任务是定期分析索引的使用情况,识别并清理“僵尸索引”——那些创建后从未或极少被查询优化器使用的索引。它们白白占用存储空间,并在每次数据写入时带来不必要的维护成本。可以通过数据库提供的系统视图或性能监控工具来发现这些索引。
索引碎片化是性能的隐形杀手。随着数据的增删改,索引页会变得不连续,导致磁盘读取从顺序变为随机,严重拖慢查询速度。定期对索引进行重建或重组,可以消除碎片,使索引数据页排列更紧凑。这就像定期整理书籍目录,确保查找路径最短。数据库的统计信息如同地图的精度,过时的统计信息会误导查询优化器选择低效的执行计划。定期更新统计信息是维持索引效能的必要环节。
高级优化技巧还包括使用“覆盖索引”和“索引下推”。覆盖索引是指一个索引包含了查询所需的所有字段,使得数据库无需回表查找数据行,极大地提升了查询速度。而“索引下推”则是将WHERE子句中的过滤条件在索引遍历阶段就进行应用,减少需要回表检查的行数。例如,查询“状态为已支付且金额大于100的订单”,如果在(用户ID,状态,金额)的索引上进行查询,并利用索引下推,可以提前过滤掉不满足金额条件的记录,显著提升性能。
避坑指南:常见失效场景分析
即使精心设计了索引,一些不经意的操作也可能使其瞬间“失效”,导致查询性能断崖式下跌。最典型的陷阱之一是对索引列进行函数操作或计算。例如,在WHERE子句中对日期列使用YEAR(create_time)=2023,或者对字符串列使用LEFT(name, 3)=‘ABC’,通常会导致数据库无法使用该列上的索引,转而进行全表扫描。正确的做法是尽量将计算转移到常量端。
隐式类型转换是另一个常见的性能杀手。如果为字符类型的列创建了索引,但在查询时使用了数字类型的值进行比较(例如 WHERE phone = 13800138000),数据库可能会进行隐式类型转换,从而使索引失效。确保查询条件中的数据类型与列定义严格一致至关重要。使用NOT、<>、NOT IN等否定操作符,或者对索引列使用OR连接多个条件(且这些条件并非覆盖同一复合索引),也容易导致索引使用不充分。
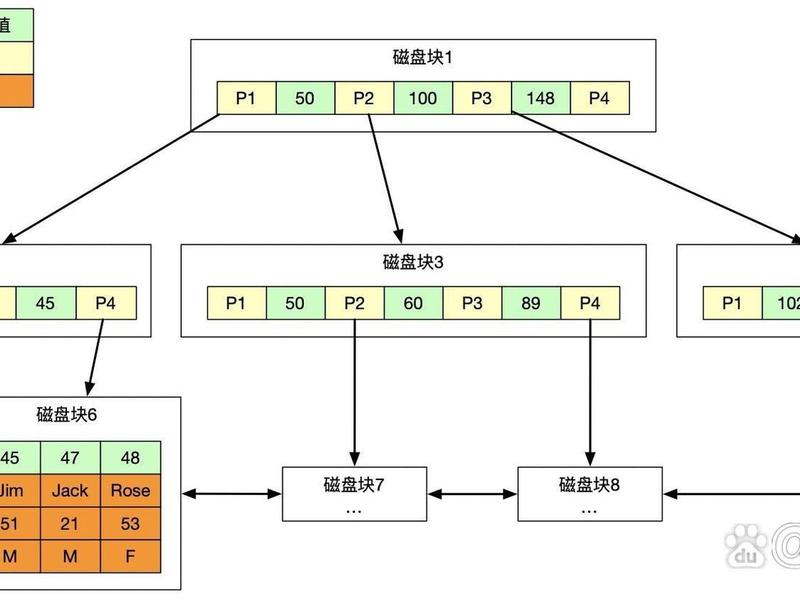
使用LIKE进行模糊查询时,以通配符‘%’开头的模式(如‘%关键字’)同样无法有效利用索引。索引的B+树结构决定了它只能高效匹配前缀。对于必须进行后缀匹配或中间匹配的场景,可能需要考虑使用全文索引或其他专门的搜索引擎。了解这些陷阱,并在编写SQL和设计索引时主动规避,是保证数据库查询持续高效的关键。
未来趋势:智能化与自适应管理
随着数据库技术的演进,索引的管理正朝着自动化和智能化的方向发展。传统依赖DBA经验的手工调优模式,在面对微服务架构下成百上千个数据库实例时已力不从心。云数据库服务商纷纷推出了智能索引管理功能,它们基于对历史工作负载的深度分析,能够自动推荐该创建哪些索引、优化现有索引,甚至安全地删除无用索引。
这些系统通过机器学习模型,持续分析SQL查询模式,识别出哪些索引能带来最大的性能收益,并评估其创建后的维护成本。一些先进的系统支持“虚拟索引”或“不可见索引”功能,允许在不影响生产环境的前提下,模拟测试新索引的效果。自适应索引技术也开始崭露头角,它能够根据查询负载的变化,动态调整索引的结构或选择性纳入新的列,实现索引与业务需求的同步进化。
展望未来,索引管理将更加紧密地与整体数据库运维融合。它不再是孤立的技术点,而是数据库自治运维(Self-Driving Database)的重要组成部分。从自动创建、效果评估、碎片整理到生命周期管理,索引的全流程都将由智能系统接管,让开发者能更专注于业务逻辑创新,而将数据库性能优化的重担交给更可靠、不知疲倦的AI引擎。这标志着数据库管理从“手工技艺”向“智能科学”的深刻转变。
以上是关于数据库创建和管理索引 - 数据库创建和管理索引的方法的介绍,希望对想了解建站百科知识的朋友们有所帮助。
本文标题:数据库创建和管理索引 - 数据库创建和管理索引的方法;本文链接:https://zwz66.cn/jianz/366609.html。
猜你喜欢
- 数据库创建失败是怎么回事、数据库创建失败怎么解决 2026-10-02
- 数据库创建与管理的实训总结;数据库创建与管理实验总结 2026-10-02
- 数据库创建与管理 数据库创建与管理实验报告 2026-10-02
- 数据库mysql建表新手使用教程;怎样用mysql建立数据库表格 2026-10-02
- 数据库 建设(数据库建设收费标准) 2026-10-02
- 摄影工作室创业方法;摄影工作室创业方法有哪些 2026-10-02
- 搜狗百科如何创建;搜狗百科如何创建搜索引擎 2026-10-02
- 搜狗按步骤创建词库 - 搜狗按步骤创建词库怎么弄 2026-10-02
- 搜狗怎样创建自己的网站;搜狗怎样创建自己的网站链接 2026-10-02
- 搜狗创作平台 - 搜狗创作平台下载 2026-10-02







