大数据平台技术架构 大数据平台技术架构包括
-
大,数据,平台,技术,架构,包括,在,数据,爆炸,

- 建站百科知识-小虎建站百科知识网
- 2026-11-18 00:53
- 小虎建站百科知识网
大数据平台技术架构 大数据平台技术架构包括 ,对于想了解建站百科知识的朋友们来说,大数据平台技术架构 大数据平台技术架构包括是一个非常想了解的问题,下面小编就带领大家看看这个问题。
在数据爆炸的时代,企业如同航行在信息海洋中的巨轮,而大数据平台技术架构,正是这艘巨轮的龙骨与引擎。它不仅仅是技术的堆砌,更是一套将原始、无序的数据洪流,转化为清晰、可操作的商业洞察的精密系统。一个稳健、高效且可扩展的大数据平台技术架构包括数据采集与接入、分布式存储、计算引擎、资源管理与调度、数据治理与服务化等多个核心层次。理解这套架构,就如同掌握了从数据矿山中提炼黄金的炼金术,是企业在数字化竞争中构建核心优势、实现智能决策的基石。本文将带您深入这座数据工厂的内部,揭开其技术面纱,探寻如何通过精妙的架构设计,让数据真正成为驱动未来的新石油。
数据之源:全域采集与实时接入
大数据之旅始于数据的汇聚。大数据平台技术架构的底层基石,是强大而灵活的数据采集与接入层。它如同遍布各处的感官神经,需要从各类异构数据源中“汲取养分”。这些数据源形态万千,包括关系型数据库的增删改查日志、服务器源源不断产生的应用程序日志、遍布全球的网站点击流、物联网设备实时上报的传感器数据,乃至社交媒体上的文本、图像与视频。
传统的批量ETL(抽取、转换、加载)工具,如Sqoop、DataX,负责将历史数据从业务库周期性迁移至数据仓库。而在实时性要求极高的场景下,架构必须拥抱流式接入。以Apache Kafka、Pulsar为代表的消息队列,扮演了“数据高速公路”的角色,它们以高吞吐、低延迟的特性,将实时事件流无损地传输至下游系统,确保业务动态能被瞬间感知。针对日志类的半结构化数据,Filebeat、Logstash等轻量级采集器被广泛部署,实现高效的日志收集与初步解析。
这一层的设计哲学在于“海纳百川”与“化繁为简”。它不仅要支持多种协议和格式,更要具备应对数据源突发洪峰的能力,确保数据入口的稳定与可靠。优秀的接入层如同一个智能的过滤器与转换器,在数据进入核心系统前,完成格式标准化、脏数据清洗等初步工作,为后续的深度加工奠定洁净的原料基础。
存储之基:分布式与多模存储
当数据如潮水般涌入,如何安全、可靠且高效地存储它们,是架构面临的第二大挑战。现代大数据平台技术架构彻底摒弃了单一存储的思维,转向基于廉价商用硬件的分布式、多模存储体系。这构成了平台的“数据湖”或“数据仓库”本体,是数据资产的永久性或长期存放地。
分布式文件系统HDFS(Hadoop Distributed File System)是这一领域的经典基石。它将超大文件切割成块,分散存储在成百上千台服务器上,通过多副本机制保障数据可靠性,实现了“分而治之”的存储哲学。而对象存储(如AWS S3、阿里云OSS)因其无限的扩展性和高可用性,已成为云上数据湖的事实标准,完美承载原始数据、备份数据和计算结果。
并非所有数据都适合文件形式。于是,大数据平台技术架构包括了丰富的多模数据库。对于需要高并发随机读写的在线业务数据,HBase、Cassandra等列式NoSQL数据库大显身手;对于复杂的关联查询与分析,像ClickHouse这样的MPP(大规模并行处理)分析型数据库提供了极致速度;而对于图关系数据,Neo4j等图数据库则提供了原生支持。这种“因材施储”的策略,使得平台能够以最优成本与性能应对多样化的数据形态与访问模式。
计算之力:批流融合与智能计算
存储是静态的,而计算是赋予数据生命的动态过程。大数据平台技术架构的核心引擎在于其强大的计算能力。根据时效性要求,计算范式主要分为批处理和流处理。以MapReduce为代表的早期批处理框架,擅长处理海量历史数据的离线分析,但其高延迟特性已无法满足实时需求。
如今,架构正朝着“批流一体”的方向演进。Apache Spark凭借其内存计算和DAG(有向无环图)执行引擎,大幅提升了批处理性能,同时其Structured Streaming模块提供了微批处理的流计算能力。而真正意义上的低延迟流处理王者Apache Flink,以其“事件时间”语义和精确一次的状态一致性保证,在实时风控、实时推荐等场景中不可或缺。Flink与Spark的并存与融合,让平台能够同时驾驭“历史深海”与“实时溪流”。
更进一步,计算层正在与人工智能深度融合。平台开始集成机器学习框架(如TensorFlow、PyTorch)和特征工程平台,使得数据无需离开平台即可完成从预处理、特征提取到模型训练、评估部署的全流程。计算,从此不再仅仅是统计与聚合,更是演变为挖掘数据深层规律、生成预测与决策的“智能大脑”。
调度之魂:资源管理与作业编排
在一个拥有成千上万台服务器、同时运行数万个计算任务的大数据平台上,如何高效、公平地分配资源并有序编排作业流程,是确保平台稳定高效运行的“中枢神经系统”。这便是资源管理与调度层,它决定了集群的利用效率和任务执行的顺畅度。
YARN(Yet Another Resource Negotiator)是Hadoop生态中经典的集中式资源管理器,它将集群的计算资源(CPU、内存)抽象化,按需分配给MapReduce、Spark等计算框架。而更现代的Kubernetes,凭借其强大的容器编排能力,正逐渐成为云原生大数据平台的首选调度器。它使得大数据组件可以像微服务一样被容器化部署、弹性伸缩和统一管理,极大地提升了资源的弹性和运维效率。
在作业编排层面,仅仅启动任务远远不够。复杂的业务数据处理往往需要多个任务按照特定依赖关系有序执行。这就需要像Apache Airflow或DolphinScheduler这样的工作流调度系统。它们允许数据工程师以代码(Python或DSL)的方式定义任务DAG,可视化地监控任务运行状态,并在失败时自动重试或告警。这一层确保了从数据接入到最终报表生成的整个数据流水线,能够像精密钟表一样准确、自动地运转。
治理与服务:从数据资产到数据产品
当数据被妥善存储和计算后,如何确保其质量、安全并便捷地交付给最终用户,是体现大数据平台技术架构成熟度的关键。数据治理与服务化层,旨在将原始数据提升为可信、可用的数据资产,乃至直接可消费的数据产品。
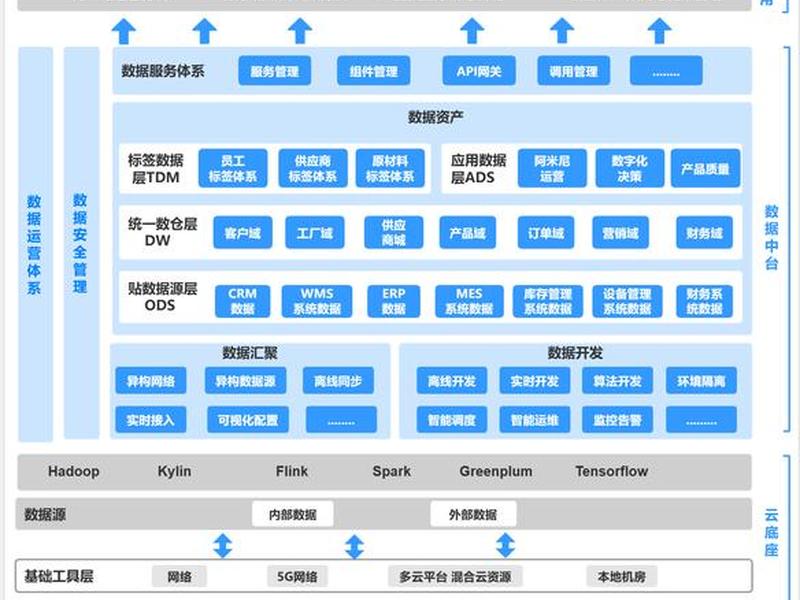
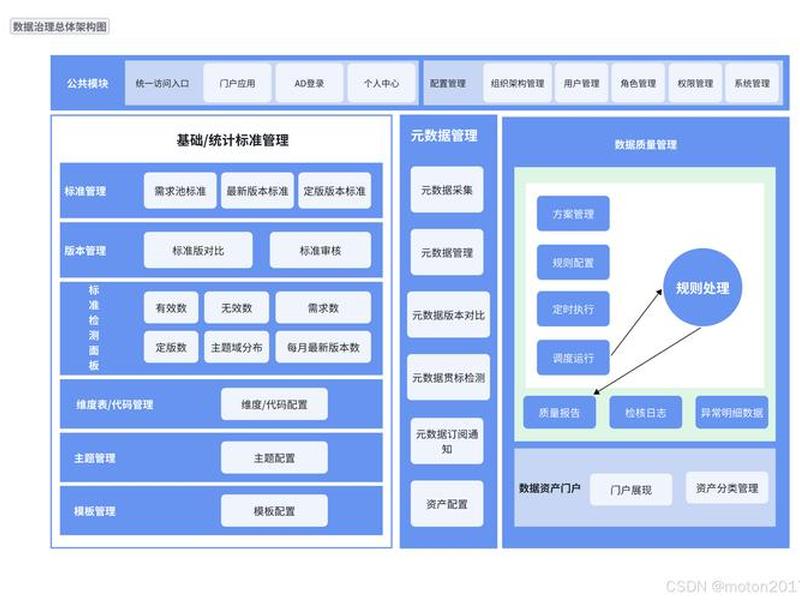
数据治理是这一层的基石,它包括元数据管理(记录数据的来龙去脉)、数据血缘追踪(分析数据的加工链路)、数据质量管理(设定并监控数据的准确性、完整性规则)以及主数据管理。通过这一系列措施,平台中的数据不再是混乱的“黑盒”,而是标签清晰、血统纯正、质量可靠的“标准化零件”。
在此基础上,数据服务化是价值释放的最后一公里。平台通过构建统一的数据服务层,将复杂的数据存储和计算逻辑封装成标准的API(应用程序接口)或SQL查询服务。无论是数据科学家通过Jupyter Notebook进行探索式分析,还是业务分析师通过BI工具(如Tableau、帆软)制作报表,或是业务系统直接调用数据接口,都能以一致、安全、高效的方式获取所需数据。这使得数据能力得以产品化,真正赋能到企业的每一个角落,驱动业务创新。
架构演进:云原生与湖仓一体
大数据平台技术架构并非一成不变,它正随着技术浪潮快速演进。当前最显著的趋势是云原生与湖仓一体。云原生架构意味着大数据组件全面容器化,利用Kubernetes实现弹性伸缩、敏捷部署和混合云管理,极大降低了运维复杂度并提升了资源利用率。平台正从笨重的“大象”转变为灵动而富有弹性的“有机体”。
“湖仓一体”(Lakehouse)则是存储与计算范式的一次重要融合。它试图打破数据湖(存储灵活但缺乏事务和管理)与数据仓库(管理严格但格式僵化)的界限。以Databricks Delta Lake、Apache Iceberg和Hudi为代表的开放表格式,在廉价的对象存储之上,提供了类似数据仓库的ACID事务、版本管理和高效upsert能力。这使得平台可以在同一套存储上,同时支撑数据科学探索、机器学习和传统BI分析,实现了成本、灵活性与性能的更好平衡。
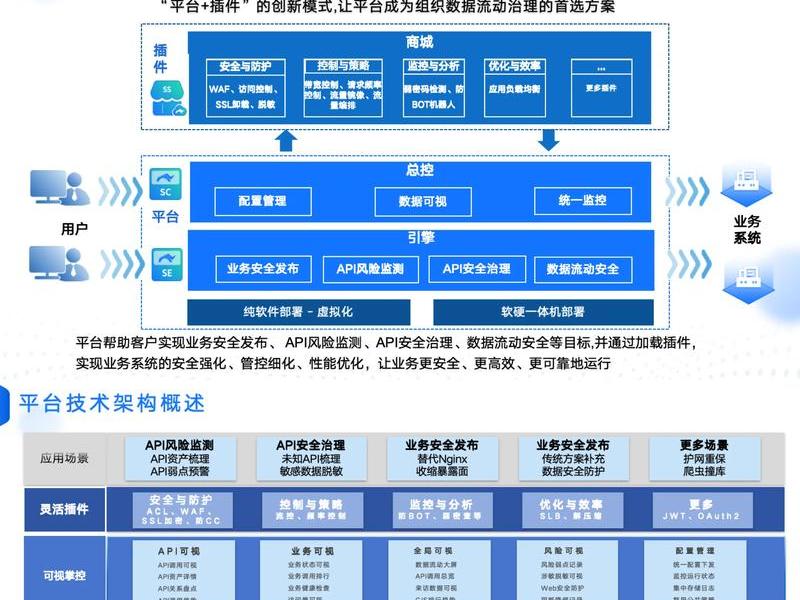
未来,架构将更加智能化、自动化与平民化。AI for DataOps将用机器学习优化数据管道性能;自动化数据发现与集成将降低数据准备门槛;低代码数据开发工具将让更多业务人员参与到数据价值创造中。架构的终极目标,是让数据能力的获取如同使用水电一样简单、即时。
以上是关于大数据平台技术架构 大数据平台技术架构包括的介绍,希望对想了解建站百科知识的朋友们有所帮助。
本文标题:大数据平台技术架构 大数据平台技术架构包括;本文链接:https://zwz66.cn/jianz/416200.html。
猜你喜欢
- 大数据平台搭建方案(大数据平台搭建方案设计) 2026-11-18
- 大数据全国今日疫情 - 大数据疫情全国最新公布 2026-11-18
- 大数据seo获客思维、大数据seo获客思维案例分析 2026-11-18
- 大律师网推广效果怎么样 大律师网推广效果怎么样啊 2026-11-18
- 大庆网站设计、大庆网站设计师招聘 2026-11-18
- 大庆网站建设费用;网站建设要费用多少 2026-11-18
- 大庆网站建设电话(大庆建设网官方网站) 2026-11-18
- 大庆网站建设方案模板 大庆建设网官方网站 2026-11-18
- 大庆网站建设搭建 大庆建设网官方网站 2026-11-18
- 大庆现代化网站设计指导 大庆现代化网站设计指导中心 2026-11-18







