python人像分割 python opencv图像分割
-
python,人像,分割,opencv,图像,在,数字,图像

- 建站百科知识-小虎建站百科知识网
- 2026-10-29 04:36
- 小虎建站百科知识网
python人像分割 python opencv图像分割 ,对于想了解建站百科知识的朋友们来说,python人像分割 python opencv图像分割是一个非常想了解的问题,下面小编就带领大家看看这个问题。
在数字图像处理的浩瀚宇宙中,Python人像分割与OpenCV图像分割正如同两把璀璨的钥匙,共同开启了通往智能视觉世界的神秘大门。想象一下,只需几行简洁的代码,就能让照片中的人物从纷繁复杂的背景中“跃然而出”,实现媲美专业软件的抠图效果,甚至为视频直播增添实时虚化背景的魔力。这并非科幻,而是当下每个开发者触手可及的现实。本文将带你深入探索这一融合了前沿算法与强大工具的技术领域,无论你是渴望快速上手的初学者,还是寻求性能优化的进阶者,这里都有你想要的答案。
技术核心:OpenCV的基石作用
OpenCV作为计算机视觉领域的“瑞士军刀”,为Python人像分割提供了坚实而丰富的基础设施。它并非一个单一的分割算法,而是一个集成了图像加载、预处理、矩阵运算、轮廓查找和结果可视化的完整工具箱。通过`cv2`模块,开发者可以轻松读取各种格式的图像,将其转换为便于处理的数值矩阵。
更重要的是,OpenCV内置了多种传统的图像分割方法,如基于阈值的分割、边缘检测(Canny算子等)、以及分水岭算法。这些方法虽然不如深度学习模型在复杂人像分割上精准,但在特定场景(如背景对比强烈)下,它们具有速度极快、无需训练的优势,是理解分割原理的绝佳起点。掌握这些基础,就如同掌握了建造大厦的砖瓦,是迈向更高级深度学习模型的必经之路。
OpenCV在后期处理中扮演着不可或缺的角色。即使使用深度学习模型得到初始分割掩膜(Mask),往往也需要利用OpenCV进行形态学操作(如膨胀、腐蚀)来平滑边缘,或使用`findContours`函数来提取和优化人物轮廓。这种“深度学习模型+OpenCV后处理”的 pipeline,是工业界常见的高效实践。
深度学习革命:模型驱动的精准分割
当传统方法遇到复杂发丝、透明衣物或混乱背景时,便显得力不从心。深度学习的兴起,彻底改写了人像分割的游戏规则。一系列专为分割任务设计的神经网络架构应运而生,如U-Net、DeepLabv3+、Mask R-CNN等。这些模型能够像一位拥有“火眼金睛”的艺术家,理解图像的高级语义信息,从而做出像素级的精准判断。
在Python生态中,我们可以借助强大的深度学习框架来驾驭这些模型。TensorFlow和PyTorch是两大主流选择,它们提供了构建、训练和部署分割模型的完整环境。社区中更是存在大量预训练好的人像分割模型,例如Google的MediaPipe Selfie Segmentation、百度的PaddleSeg等。开发者只需寥寥数行代码,即可加载这些模型,实现对输入图像的实时或高精度分割,大大降低了技术门槛。
模型的部署与优化同样关键。为了在资源受限的边缘设备(如手机)上运行,常常需要对模型进行量化、剪枝等优化操作。OpenCV的DNN模块在此大显身手,它支持直接加载由TensorFlow或PyTorch导出的优化后模型,并利用其底层的高度优化代码进行高效推理,实现了性能与精度的完美平衡。
实战流程:从图像到掩膜的旅程
一次完整的人像分割实战,是一次精心设计的旅程。旅程的起点是图像预处理。原始图像可能尺寸不一、含有噪声或光照不均。通常,我们需要使用OpenCV将图像缩放到模型规定的输入尺寸,并进行归一化处理(如将像素值从0-255缩放到0-1之间),有时还需要进行色彩空间的转换(BGR转RGB),以满足不同模型的要求。
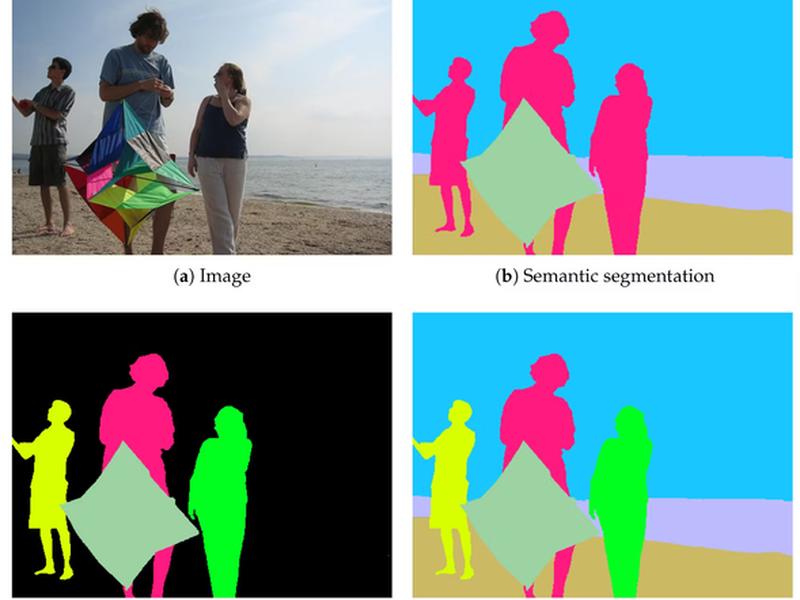
接下来是核心的推理阶段。将预处理后的图像数据输入到加载好的深度学习模型中。模型经过前向传播,会输出一个与输入图像空间尺寸对应的二维矩阵,即分割掩膜。掩膜中每个像素的值代表了该像素属于“人物”类别的置信度或二值化标签(0为背景,255为人物)。这个过程在强大的GPU上可以快到毫秒级,实现视频流的实时处理。
旅程的终点是后处理与合成。原始的模型输出可能边缘粗糙或有小孔洞。OpenCV的用武之地再次显现。我们可以应用高斯模糊平滑边缘,通过阈值化将概率掩膜转为二值图像,再利用形态学操作消除细小噪声。利用这个精致的掩膜,通过`cv2.bitwise_and`等操作,可以将原图中的人物完美提取出来,并合成到任何想要的背景之中,创造出令人惊叹的效果。
性能优化:速度与精度的博弈艺术
在实际应用中,尤其是在实时视频处理场景下,性能优化是永恒的课题。优化是一场在速度与精度之间寻求最佳平衡点的艺术。模型的选择至关重要。轻量级模型如MobileNetV3+DeepLabv3,在精度略有妥协的情况下,带来了数量级的速度提升,非常适合移动端和实时应用。
推理引擎的优化至关重要。除了使用OpenCV DNN模块,还可以考虑专为推理优化的框架,如TensorRT(针对NVIDIA GPU)或OpenVINO(针对Intel硬件)。这些工具能将模型转化为针对特定硬件高度优化的格式,极大提升推理效率。降低推理图像的分辨率是提升速度最直接有效的方法之一,当然这需要评估对精度的实际影响。
代码层面的优化也不容忽视。利用Python的NumPy进行向量化操作,避免低效的循环;合理利用多线程或异步处理来并行处理视频帧;对于固定场景,甚至可以预先计算背景模型以减少计算量。这些“微操作”累积起来,往往能带来意想不到的性能提升。
创新应用:超越抠图的无限可能
人像分割技术的魅力,远不止于简单的“换背景”。它已成为一系列创新应用的基石。在在线会议和直播领域,实时人像分割实现了优雅的背景虚化或替换,让用户在任何地方都能保持专业的形象。在影视后期和摄影领域,它自动化了原本繁琐的抠图流程,释放了创作者的精力。
在增强现实(AR)和虚拟试衣中,精准的人像分割是虚拟物体与真实人物正确交互、遮挡关系得以实现的前提。在智能零售领域,可以分析顾客与商品的互动。甚至在健身和医疗领域,通过分析分割后的人体姿态,可以进行动作矫正或体态评估。这些应用不断拓展着技术的边界,也反过来推动着分割算法向更精准、更鲁棒的方向进化。
更重要的是,随着技术的平民化,普通开发者甚至爱好者也能基于这些开源工具,创造出属于自己的有趣应用,如制作创意短视频、开发个性化贴纸App等。技术的门槛正在消失,创意的天空无限广阔。
未来展望:技术融合与新范式
展望未来,Python人像分割与OpenCV图像分割技术将继续深度融合与演进。一方面,Transformer架构在视觉领域的成功,正催生新一代更强大的分割模型(如Segment Anything Model),这些模型对边缘和细节的处理将更加细腻。三维人像分割和视频时序分割将成为热点,旨在从动态序列中获取更稳定、连贯的分割结果。
无监督和弱监督学习将成为重要方向,致力于减少模型对大量精细标注数据的依赖,让模型学会“自学成才”。边缘计算与AI芯片的发展,将使高精度实时分割在手机、IoT设备上无处不在。OpenCV等基础库也将持续进化,更好地支持这些新兴模型和硬件,为开发者提供更强大、更易用的工具链。
最终,技术将越来越“隐形”,深度融合到各行各业的工作流和日常生活体验中,成为一种如水如电般的基础设施。而Python与OpenCV,将继续作为连接创意与实现的最重要桥梁。
Python人像分割与OpenCV图像分割的结合,是一场算法、工具与创意的华丽共舞。从OpenCV提供的坚实土壤,到深度学习模型带来的认知飞跃,再到实战流程中的精心打磨与性能优化,这条技术路径清晰地展示了如何将前沿AI理论转化为切实可用的应用。它不仅在改变专业领域的工作方式,更在赋能每一个个体进行视觉创造。掌握这套工具,就如同掌握了一种视觉魔法,能够将想象从脑海中抽取,定格于数字世界。这场探索之旅没有终点,因为技术与想象力的结合,永远充满新的可能。
以上是关于python人像分割 python opencv图像分割的介绍,希望对想了解建站百科知识的朋友们有所帮助。
本文标题:python人像分割 python opencv图像分割;本文链接:https://zwz66.cn/jianz/393305.html。
猜你喜欢
- Python人工智能介绍;python人工智能介绍 2026-10-29
- Python人事管理系统 - python人事管理系统 2026-10-29
- python人事档案管理系统源码;python人力资源管理系统 2026-10-29
- python3.8在线,python3.8在线编辑器 2026-10-29
- python123网站 - python123网站登录 2026-10-29
- python dog、python dog_adoption.py 2026-10-29
- HTML烟花特效 - html代码烟花特效python 2026-10-27
- html烟花效果图(html代码烟花特效python) 2026-10-27
- 零基础入门学习python - 零基础学python从入门到精通 2026-10-17
- 零基础入门学python清华大学出版社编码是多少,清华大学出版社python从入门到精通 2026-10-17







