netmhcpan教程(netmhcpan4.0)
-
netmhcpan,教程,netmhcpan4.0,在,精准

- 建站百科知识-小虎建站百科知识网
- 2026-10-28 14:05
- 小虎建站百科知识网
netmhcpan教程(netmhcpan4.0) ,对于想了解建站百科知识的朋友们来说,netmhcpan教程(netmhcpan4.0)是一个非常想了解的问题,下面小编就带领大家看看这个问题。
在精准医疗的浪潮中,个体化肿瘤免疫治疗正成为攻克癌症的希望灯塔。而这一切的核心密码,潜藏在那些由肿瘤细胞突变产生的独特“身份标签”——新生抗原之中。如何从海量的基因突变数据中,精准地预测出这些能够被免疫系统识别的关键肽段?答案,就藏在今天的主角——NetMHCpan 4.0之中。它被誉为预测肽段与MHC-I类分子结合亲和力的“金标准”,是连接基因组学与临床免疫疗法的桥梁。本文将带你深入NetMHCpan 4.0的世界,从核心原理到实战操作,手把手教你驾驭这把解锁肿瘤免疫奥秘的金钥匙。
NetMHCpan 4.0 核心原理
NetMHCpan 4.0并非凭空诞生,它的强大源于算法的革命性进化。传统预测工具大多仅依赖肽段与MHC分子的结合亲和力数据,这好比只通过一把钥匙的形状来判断能否开锁,忽略了锁芯内部的复杂构造。NetMHCpan 4.0的突破在于,它创造性地整合了两种关键数据源:基于实验测定的定量结合亲和力数据,以及通过质谱技术捕获的“洗脱配体”数据。
质谱数据如同一位“现场目击者”,它记录了在真实细胞环境中,哪些肽段最终被成功呈递到了细胞表面。这些数据蕴含了抗原加工、转运、与MHC复合物稳定性等复杂生物学过程的综合信号。NetMHCpan 4.0通过先进的人工神经网络框架,将这两种数据流融为一体进行训练。这使得模型不仅能评估肽段与MHC分子“静态结合”的强度,更能模拟其在体内“成功呈递”的动态概率,预测准确性实现了质的飞跃。
该模型已针对超过81种人类MHC等位基因以及多种动物模型进行了专门训练,尤其擅长处理9个氨基酸长度的经典肽段。这种基于大数据与深度学习融合的策略,让它从众多预测工具中脱颖而出,成为研究人员信赖的行业标杆。
软件安装与环境配置
工欲善其事,必先利其器。获取NetMHCpan 4.0通常需要通过官方网站进行申请,使用教育或机构邮箱有助于顺利获得授权。下载后,你将得到两个核心文件:主程序压缩包和必不可少的数据包。第一步是解压主程序,这会在你的目录中生成一个名为“netMHCpan-4.1”的文件夹。
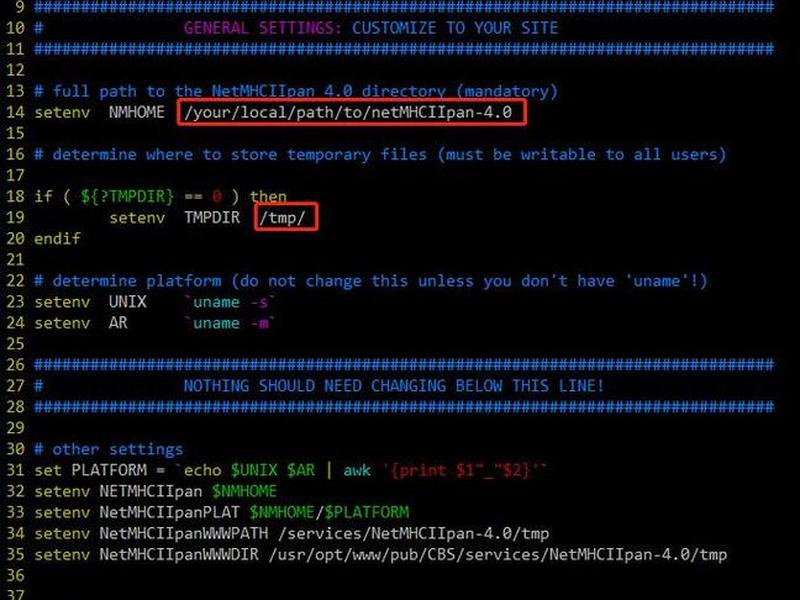
紧接着,最关键的一步是将下载的`data.tar.gz`数据包放入上述文件夹内并解压。这个数据包包含了所有预训练的模型和等位基因信息,是软件运行的“大脑”,缺它不可。之后,你需要编辑软件目录下的配置文件(通常是名为`netMHCpan`的脚本),正确设置两个环境变量:`NMHOME`(指向软件主目录)和`TMPDIR`(指向临时文件目录)。
许多新手会在运行时遇到“command not found”的错误,这往往是因为系统缺少必要的运行环境。确保你的系统已安装`tcsh`解释器。为了方便日常使用,可以为可执行文件创建一个软链接到`/usr/local/bin/`这样的系统路径,这样在任何位置都能直接调用`netMHCpan`命令。
实战演练:预测流程详解
安装配置完成后,激动人心的实战环节正式开始。预测的输入是你的目标蛋白序列,格式必须是标准的FASTA格式。这里有一个至关重要的细节:对于肿瘤新抗原预测,你提交的应该是包含体细胞突变位点后的突变型氨基酸序列,而非野生型序列,因为新生抗原正源于这些特异的突变。
提交序列后,你需要进行关键参数设置。首先是肽段长度选择,MHC-I类分子通常呈递8到11个氨基酸的短肽,你可以根据需求勾选相应的长度范围。其次是选择HLA等位基因型,这是决定预测特异性的核心。准确的患者HLA分型信息是获得可靠结果的前提。
点击提交后,算法便开始工作。它会将输入的长序列滑动切割成指定长度的小肽段,并利用训练好的神经网络模型,逐一计算每个肽段与指定MHC分子的结合强度。这个过程虽然复杂,但软件背后已为你完成了所有繁重的计算。
结果解读与深度分析
当分析完成,面对满屏的数据,如何从中淘金?输出结果包含多列关键信息。“Peptide”列展示的是从序列中切割出的候选肽段序列;“Pos”列指示该肽段在原始序列中的起始位置;而“Core”列则标出了与MHC分子结合最核心的锚定残基区域。
最需要关注的是“%Rank”和“BindLevel”这两列。%Rank值是一个归一化的排名百分比,它表示该肽段与一堆随机肽段相比的强弱,数值越小,表明该肽段是天然配体的可能性越高。通常,%Rank < 0.5被视为强结合,0.5至2之间被视为弱结合。“BindLevel”列则直接给出了“SB”(强结合)或“WB”(弱结合)的定性判断。
值得注意的是,没有任何计算模型是完美的。曾有研究报道,某些通过质谱实验确证能够结合HLA的肽段,其NetMHCpan预测的亲和力却很低。这提示我们,软件预测结果应作为重要的初筛工具,而非绝对真理,最终仍需结合实验验证进行综合判定。
在新生抗原预测中的应用
NetMHCpan 4.0最重要的应用场景之一,便是肿瘤新生抗原的筛选。在个体化癌症疫苗或T细胞疗法开发中,研究人员需要从患者肿瘤组织测序发现的成千上万个突变中,找出最有可能激活特异性免疫反应的那几个“精英肽段”。
单独使用NetMHCpan进行大规模分析略显繁琐,一系列自动化流程应运而生。例如,像NeoPredPipe这样的工具,可以整合整个分析管线:用户只需提供体细胞突变的VCF文件和患者的HLA分型结果,软件便能自动提取突变序列、调用NetMHCpan进行计算、并格式化输出结果。这极大提高了研究效率,使得快速、批量化的新生抗原筛选成为可能。
通过这套流程,我们可以从海量突变中快速锁定一批候选新抗原。这仅仅是万里长征的第一步。计算预测的假阳性率仍然存在,后续必须通过体外结合实验、T细胞激活实验等多重生物学验证,才能最终确认真正具有免疫原性的治疗靶点。
面临的挑战与未来展望
尽管NetMHCpan 4.0已是领域翘楚,但挑战依然存在。当前工具对MHC-II类分子的预测能力仍弱于MHC-I类,这源于II类分子结合沟槽更开放、结合肽段长度可变且数据更稀缺。面对人类种群中极高的HLA等位基因多样性,如何准确预测那些缺乏训练数据的“零样本”等位基因,是精准医疗面临的巨大瓶颈。
未来的发展将更加注重多维度信息的整合。例如,最新的MHC-flurry 2.0等工具,开始尝试将抗原加工、转运等呈递通路中的其他环节单独建模,再与结合亲和力预测整合,模拟更完整的生物学过程。随着人工智能技术的演进,Transformer等更强大的模型架构,以及更大规模的免疫肽组学数据,正在推动预测精度向新的高度迈进。
以上是关于netmhcpan教程(netmhcpan4.0)的介绍,希望对想了解建站百科知识的朋友们有所帮助。
本文标题:netmhcpan教程(netmhcpan4.0);本文链接:https://zwz66.cn/jianz/392557.html。
猜你喜欢
- nba网页设计教程html(基于html关于nba的网页制作) 2026-10-28
- nba图标设计教程(nba图标设计教程简单) 2026-10-28
- nba主题网页设计教程视频、nba主题网页设计教程视频大全 2026-10-28
- nba主题网页设计教程手机版(nba主题网页设计教程手机版下载) 2026-10-28
- nba主题网页设计教程图片;nba主题网页设计教程图片高清 2026-10-28
- nba主题网页设计教程、nba主题网页设计教程视频 2026-10-28
- markdown如何制作网页教程(markdown发布成网页) 2026-10-28
- linux虚拟机安装samba教程;linux虚拟机安装macos 2026-10-28
- linux服务器搭建网站 linux服务器搭建网站教程 2026-10-28
- linux搭建网站教程,简单来说,linux网站搭建步骤 2026-10-28







