html访问网页(html网页设如何置访问密码)
-
html,访问,网页,设,如何,置,密码,在,浩瀚,无垠,

- 建站百科知识-小虎建站百科知识网
- 2026-10-27 21:24
- 小虎建站百科知识网
html访问网页(html网页设如何置访问密码) ,对于想了解建站百科知识的朋友们来说,html访问网页(html网页设如何置访问密码)是一个非常想了解的问题,下面小编就带领大家看看这个问题。
在浩瀚无垠的互联网世界中,每一个网页都是一片私密的数字花园,或是存放珍贵数据的虚拟宝库。你是否曾担忧,那些本不该公之于众的页面,会被陌生访客无意间闯入?当“HTML网页如何设置访问密码”这个问题浮现在脑海时,你寻找的不仅仅是一行代码,更是一把守护数字领地的钥匙。这看似简单的需求背后,蕴藏着从基础到进阶的多重路径,每一种方法都像是一道独特的魔法屏障,既能保护隐私,又可能悄然影响搜索引擎对你领地的“造访”。本文将为你揭开这些秘密屏障的构建之道,从最原始的`.htaccess`密码锁,到JavaScript的动态守卫,再到服务器端的坚实堡垒,带你探索如何在保护内容的与搜索引擎达成微妙平衡,让你的数字王国既安全又可见。
基础屏障:.htaccess与htpasswd的经典守护
这是最传统、也最受服务器原生支持的密码保护方式,如同一道安装在服务器入口处的铁门。它不依赖于网页本身的HTML代码,而是在服务器层面进行拦截。你需要创建两个关键文件:`.htaccess`和`.htpasswd`。`.htaccess`文件是一个配置文件,放置在需要保护的目录下,其中指明了身份验证的类型、用户文件路径等信息。而`.htpasswd`文件则像一本花名册,以加密形式存储着用户名和对应的密码。
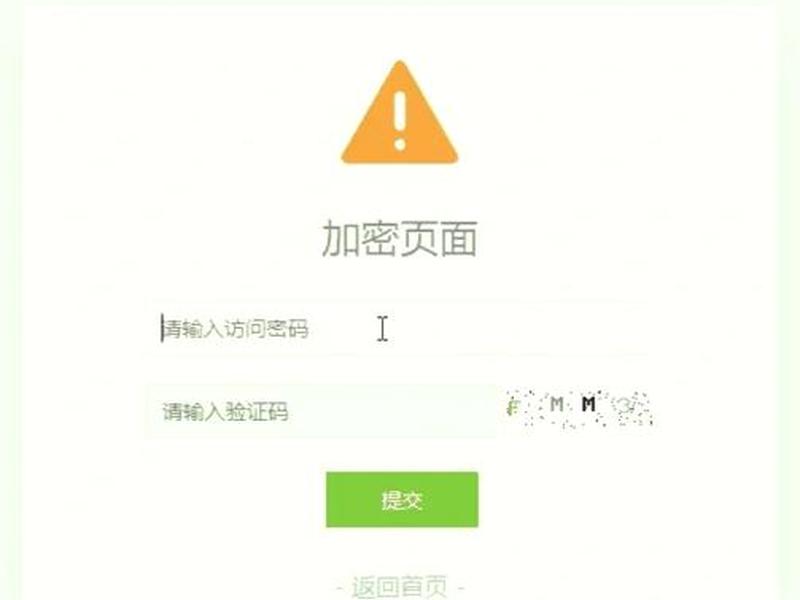
这种方法的优势在于其强大的安全性和普适性。由于验证发生在服务器向浏览器发送任何网页内容之前,因此即使访客查看网页源代码,也无法绕过这层保护。它几乎被所有主流的Apache服务器(以及许多兼容的Nginx配置)所支持,设置成功后,用户访问时浏览器会弹出一个标准的登录对话框,体验非常原生。它的缺点是需要你有服务器文件的访问权限(通常通过FTP或服务器控制面板),且密码文件的管理(如添加/删除用户)需要手动编辑文件,对于非技术用户略显繁琐。
更重要的是,从SEO角度看,这道“铁门”是一把双刃剑。当搜索引擎爬虫(如百度蜘蛛)尝试访问被保护的目录时,同样会被登录框拦截。大多数爬虫不会、也不能填写用户名和密码,这意味着被保护的页面内容将完全不会被搜索引擎收录。如果你希望保护的内容完全不公开,这是优点;但如果你希望部分内容可被搜索,就需要更精细的策略,例如通过`robots.txt`文件引导爬虫,或采用其他部分保护的方法。
动态前端:JavaScript的灵活之锁
如果你需要更灵活、更定制化的保护,或者没有服务器配置权限,那么基于JavaScript的前端密码验证是一个有趣的选项。这种方法的核心逻辑是:将真正的网页内容用JavaScript加密或隐藏起来,只有当用户在网页上的表单中输入正确密码后,JavaScript才会解密内容或跳转到真实页面。你可以将密码直接硬编码在JS代码中(安全性较低),或者通过AJAX向一个简单的后端接口验证(更安全)。
这种方式带来了极高的灵活性。你可以完全自定义登录界面的外观,使其与网站风格完美融合,而不是那个呆板的浏览器默认弹窗。你可以设计复杂的交互逻辑,例如尝试次数限制、验证码,甚至根据不同的密码显示不同的内容。实现门槛相对较低,只需要基础的HTML、CSS和JavaScript知识即可上手,特别适合静态网页托管平台(如GitHub Pages)的用户。
但其弱点同样明显,首当其冲的就是安全性。对于硬编码密码的方式,任何懂得查看网页源代码的人,都可以在JS文件中找到密码(尽管可以简单混淆,但绝非绝对安全)。它更适合保护重要性不高的内容,或作为一层轻量级的“礼貌性”屏障。在SEO方面,情况则更为复杂。如果真实内容完全由JS动态加载,而搜索引擎爬虫在抓取初始页面时只能看到一个空壳或登录表单,那么这些内容同样无法被索引。现代搜索引擎对JavaScript的渲染能力在不断增强,这需要你进行仔细的测试和权衡。
服务器端脚本:PHP/Node.js的坚固堡垒
对于动态网站或拥有服务器端编程能力的开发者来说,使用服务器端语言(如PHP、Python、Node.js)进行会话(Session)或基于令牌(Token)的认证,是构建强大访问控制系统的基石。这种方法不再依赖单个文件或前端代码,而是通过程序逻辑来判断用户是否有权访问。用户首次通过登录表单提交凭证,服务器验证成功后,会创建一个唯一的会话标识符并存储在服务器和用户的浏览器(Cookie)中。用户后续访问时,服务器通过检查这个会话来维持其登录状态。
这是构建会员系统、管理后台的通用方案,安全性远超前两种方法。密码和用户状态存储在服务器端,不会暴露给客户端。你可以实现精细的权限控制(RBAC),区分不同用户组能看到的内容。密码存储应使用强哈希算法(如bcrypt),极大提升了安全性。从开发和维护角度看,它也更具可扩展性,用户管理可以通过数据库轻松实现,而非操作文件。
在SEO的棋局上,这种方法给了你最大的控制权。你可以通过判断访问者的用户代理(User Agent)来区分真实用户和搜索引擎爬虫。一种常见的策略是,对于已知的友好爬虫(如百度的Baiduspider),你可以选择性地让其跳过登录验证,直接访问一些你想被收录的公开摘要或特定页面,从而实现“部分保护、部分公开”的优雅平衡。这需要高超的技术来实现,但一旦做好,就能在安全和可见性之间找到最佳契合点。
进阶整合:框架与托管平台的现代方案
当今的Web开发往往基于成熟的框架或云平台,它们提供了开箱即用的认证授权模块,将我们从底层细节中解放出来。例如,如果你使用React、Vue等前端框架,可以集成像Auth0、Firebase Authentication这样的第三方身份服务,它们提供了包括密码登录、社交登录、多因素认证等一整套解决方案。对于静态站点生成器(如Hugo、Jekyll),也有插件可以实现基于编译时或客户端的简单密码保护。
这些现代方案通常安全性更高,因为它们由专业团队维护,遵循最佳安全实践。它们大大降低了开发成本和出错概率,你只需调用API或配置插件即可。许多云托管平台(如Vercel、Netlify)也提供了原生的密码保护功能,只需在控制面板中点击几下,就能为整个站点或特定部署分支添加密码,非常适合用于预览客户网站或保护内部测试环境。
从SEO和用户体验的融合视角来看,这些方案通常考虑得更为周全。一些服务允许你为爬虫设置不同的访问规则,或者提供清晰的文档说明其SEO影响。选择这类方案时,关键是要仔细阅读其文档,了解其认证流程是在客户端还是服务器端完成,以及默认情况下对搜索引擎爬虫的处理策略,以便做出符合你内容策略的决策。
安全与SEO的永恒之舞
为HTML网页设置密码,本质上是在“限制访问”和“渴望被发现”之间走钢丝。安全措施过于严密,你的内容就成了数字孤岛,无人知晓;完全敞开大门,又可能让敏感信息暴露于外。决策的核心不在于“如何设置密码”,而在于“为什么要设置密码”。你需要明确保护内容的性质:是完全私密的内部文档,是付费才能查看的精品内容,还是仅希望增加一道简单障碍的临时页面?
答案决定了你的技术选型。对于绝对私密的内容,采用服务器端验证(.htaccess或后端会话)并任由搜索引擎将其忽略,是正确的选择。对于希望被索引但仅对部分用户开放的内容,则需要设计“公开摘要+私密详情”的模式,或利用`noindex`元标签、规范链接等SEO手段进行精细调控。记住,任何客户端(前端)的验证都只能作为体验增强或初级屏障,绝不能用于保护真正敏感的数据。
未来展望:无密码与智能访问控制
技术的脚步从未停歇,密码保护本身也在进化。无密码认证(如魔法链接、生物识别)正在兴起,它们能提供更好的用户体验和潜在的安全性。基于人工智能的智能访问控制或许将成为未来趋势,系统可以根据访问者的设备、网络、行为模式来自动判断风险并动态调整访问权限。对于网页开发者而言,保持对新技术和SEO规则的关注,才能在保护与开放之间,为你的数字领地筑起最智慧、最有效的边界。
以上是关于html访问网页(html网页设如何置访问密码)的介绍,希望对想了解建站百科知识的朋友们有所帮助。
本文标题:html访问网页(html网页设如何置访问密码);本文链接:https://zwz66.cn/jianz/391714.html。
猜你喜欢
- html语法的基本结构(简述html语法的基本结构) 2026-10-27
- html设计页面、html页面设计工具 2026-10-27
- html设计软件推荐(常用的html页面设计软件) 2026-10-27
- html设计软件、设计html需要什么软件 2026-10-27
- html设计自己的名字、如何用html写自己的名字 2026-10-27
- HTML设计网页;html网页设计作品及代码 2026-10-27
- html设计网页首页模板、html设计网页首页模板在哪 2026-10-27
- html设计网页首页教程 html设计网页首页教程图片大全 2026-10-27
- html设计网页首页代码 html设计网页首页代码怎么写 2026-10-27
- html设计网页首页 - html网站首页设计 2026-10-27







