html网页文字乱码(html网页中文乱码原因)
-
html,网页,文字,乱码,中文,原因,你,是否,

- 建站百科知识-小虎建站百科知识网
- 2026-10-27 16:12
- 小虎建站百科知识网
html网页文字乱码(html网页中文乱码原因) ,对于想了解建站百科知识的朋友们来说,html网页文字乱码(html网页中文乱码原因)是一个非常想了解的问题,下面小编就带领大家看看这个问题。
你是否曾满怀期待地打开一个网页,却发现满屏都是令人困惑的“锟斤拷”或“烫烫烫”?那些本应清晰展示的文字,却变成了一堆无法识别的乱码,仿佛闯入了一个由破碎符号组成的数字迷宫。这种令人沮丧的体验背后,隐藏着字符编码世界一场静默的“战争”。本文将带你深入探究HTML网页中文乱码的根源,揭开那些看似随机字符背后的秘密,并提供一套完整的解决思路。
字符编码的“巴别塔”困境
在数字世界的底层,所有文字——无论是优雅的汉字、流畅的英文还是复杂的符号——都必须被转换成计算机能理解的二进制代码。这个过程就像为不同语言建立字典,而“字典”的选择,就是字符编码。当网页声明使用的“字典”(如UTF-8)与服务器实际存储文字所用的“字典”(如GB2312)不一致时,混乱便产生了。
想象一下,你拿着一本英文词典去解读用中文密码写成的信件,结果必然是满纸荒唐言。网页乱码正是这种“词典错配”的直接体现。浏览器忠诚地按照HTML头部声明的编码方式去解读每一个字节,但如果字节流原本是按另一种规则生成的,解读出的字符就会面目全非。这种根本性的不匹配,是绝大多数中文乱码问题的核心症结。
更复杂的是,这个过程中可能涉及多个环节:文本编辑器的保存格式、服务器文件的存储编码、数据库的字段设置、后端程序的处理逻辑,以及最终浏览器接收到的HTTP响应头信息。任何一个环节的编码不一致,都可能在最终呈现时引发连锁反应。那些看似随机的“锟斤拷”,实际上是GBK编码中某些特定字节序列在UTF-8解码视角下的错误映射,每一个怪异字符都指向一次具体的编码转换失误。
元标签声明的“关键哨兵”
在HTML文档的``区域,那个看似不起眼的``标签,实际上扮演着至关重要的“翻译官”角色。它明确告知浏览器:“请使用我指定的编码规则来解读这份文档。”如果这个声明缺失,或者声明值与文件实际编码不符,浏览器就会陷入猜测的困境,往往导致中文变成乱码。 现代网页标准强烈推荐使用UTF-8作为统一编码。UTF-8是一种可变长度的Unicode编码,其伟大之处在于能够兼容ASCII,同时又能容纳地球上几乎所有语言的字符。将``置于``的最前端,能确保浏览器在解析任何文本内容(包括标题、脚本中的字符串)之前,就采用正确的解码器。这是一个成本最低、效果最显著的最佳实践。现实情况往往更加复杂。一些遗留系统或特定环境下的网页,可能仍然在使用GBK、GB2312等区域性编码。这时,元标签的声明必须与文件实际保存的编码严格一致。开发者有时会犯下这样的错误:用记事本将文件另存为UTF-8格式,却忘了将meta标签中的声明从“GBK”改为“UTF-8”。这个微小的疏忽,就足以让整个页面的中文内容陷入混乱。检查并确保声明与实质的统一,是排除乱码的首要步骤。
服务器响应的“隐形指令”
除了HTML文件内部的元标签,服务器在传送文件时附带的HTTP响应头,也携带着强大的编码指令。当服务器发送一个HTML文件时,它可以在HTTP头中加入`Content-Type: text/html; charset=UTF-8`这样的字段。这个来自服务器的“隐形指令”,其优先级通常高于HTML文件内部的``标签声明。
这就引入了一个潜在的冲突点:如果服务器头声明编码是A,而HTML文件内声明编码是B,浏览器应该听谁的?根据标准,HTTP头的指令具有更高的权威性。即使你的HTML文件写得完全正确,但服务器配置错误,强制指定了错误的字符集,乱码依然会发生。特别是在使用Apache、Nginx等Web服务器,或PHP、Java等动态语言生成页面时,务必检查服务器端是否设置了正确且一致的字符集头。
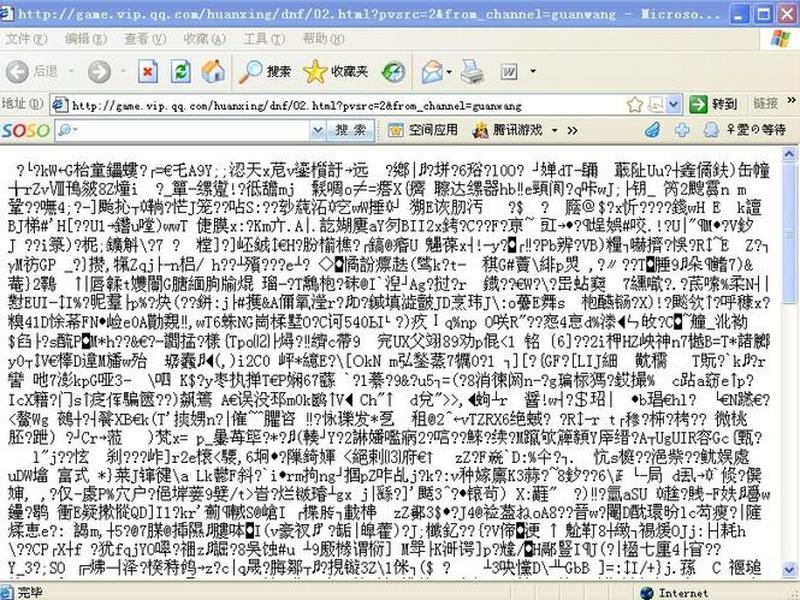
对于动态网站,这个问题尤为关键。程序从数据库读取中文数据,经过处理,最终输出到浏览器。这个链条上的每一个环节——数据库连接字符集、程序内部处理编码、输出流的编码设置——都必须统一,通常统一为UTF-8。任何一个环节的“叛变”,都可能导致最终生成的HTML片段在正确的页面框架内显示为乱码。调试时,查看网页的“网络响应头”信息,是诊断此类问题的利器。
文件存储的“源头之误”
一切数字内容的起点,是文件的创建与保存。文本编辑器(如Notepad++、VS Code、Sublime Text)在保存文件时,都需要选择一种编码格式。如果创建HTML文件时选择了“ANSI”(在中文Windows系统中通常指GBK),而后续所有处理和声明都基于UTF-8,那么乱码从源头就已注定。
许多开发者,尤其是初学者,容易忽视这个最初的步骤。他们可能专注于代码逻辑,却用默认设置保存了文件。不同的编辑器默认编码不同,跨平台协作时(如Windows与Linux),这个问题更容易被放大。一个在Windows记事本(默认ANSI)中显示正常的中文HTML文件,上传到Linux服务器后,用UTF-8环境访问,就可能出现乱码。反之亦然。
建立规范的开发流程至关重要:第一,为所有项目统一规定使用UTF-8无BOM格式作为源代码的存储编码;第二,在所使用的编辑器中,将UTF-8设置为新建文件的默认编码;第三,在团队协作工具中明确标注编码要求。从源头上保证编码一致,能消除后续大半的乱码烦恼。记住,一个健康的数字文档,其“基因”(存储编码)必须是纯净且明确的。
动态内容与数据库的“传输密码”
对于由数据库驱动的网站,乱码问题从静态文件领域延伸到了数据流动的疆域。数据的一生要经历多次“编码转换旅行”:从浏览器的表单提交(可能按页面编码),到后端程序的接收与解码,再到写入数据库的编码,最后被查询读出、由程序编码、输出到页面。这趟旅途中任何一次转码错误,都会让数据“面目全非”。
最常见的问题是数据库连接字符集与数据库表字段字符集不匹配。例如,你的程序以UTF-8编码连接MySQL,但数据库表的字符集却是Latin1。当程序试图将一条包含中文的记录写入时,乱码就可能被存入数据库本身。更棘手的是,这种乱码一旦存入,即使后续用正确的连接读取,也可能无法复原。解决方案是确保“三码合一”:连接字符集、数据库/表/字段字符集、程序内部处理编码全部统一,通常首选UTF-8mb4(它能支持更全的Unicode字符,包括表情符号)。
后端编程语言(如PHP、Python、Java)本身也有其字符串内部表示和默认编码。需要显式地在代码中指定输入输出的编码,例如在PHP中设置`mb_internal_encoding('UTF-8')`,在Python文件开头声明` -
以上是关于html网页文字乱码(html网页中文乱码原因)的介绍,希望对想了解建站百科知识的朋友们有所帮助。
本文标题:html网页文字乱码(html网页中文乱码原因);本文链接:https://zwz66.cn/jianz/391445.html。
猜你喜欢
- html网页文章 html网页文件 2026-10-27
- html网页文件的基本代码框架、html网页文件的基本代码框架包括 2026-10-27
- html网页教程;html网页设计教程 2026-10-27
- HTML网页搭建教程;html网页搭建教程 2026-10-27
- html网页插入视频,html网页制作怎么插视频 2026-10-27
- html网页排版代码 - 用html制作表格排版网页 2026-10-27
- html网页按钮代码、html中网页按钮链接代码 2026-10-27
- html网页成品(html5网页成品) 2026-10-27
- html网页成品代码大全,html网页设计作品及代码 2026-10-27
- html网页成品代码 - html网页设计作品及代码 2026-10-27







