ai训练平台的搭建;ai训练平台的搭建方法
-
训练,平台,的,搭建,方法,在,人工智能,浪潮,

- 建站百科知识-小虎建站百科知识网
- 2026-10-23 09:24
- 小虎建站百科知识网
ai训练平台的搭建;ai训练平台的搭建方法 ,对于想了解建站百科知识的朋友们来说,ai训练平台的搭建;ai训练平台的搭建方法是一个非常想了解的问题,下面小编就带领大家看看这个问题。
在人工智能浪潮席卷全球的今天,拥有一个专属的AI训练平台,已不再是科技巨头的专利,而是每个希望拥抱智能未来的组织与个人的“新基建”。它如同一位不知疲倦的超级大脑的“健身房”,是模型从懵懂到聪慧的诞生地。面对浩瀚的技术选型、复杂的资源调度与隐秘的性能陷阱,许多探索者止步于“算力荒野”,不知从何下手。本文将为你揭开AI训练平台搭建的神秘面纱,系统阐述AI训练平台的搭建方法,提供一份从概念到落地的全景路线图,助你构建高效、稳定、可扩展的智能核心引擎。
战略规划与需求锚定
搭建之旅始于清晰的战略蓝图。切勿陷入“为了技术而技术”的陷阱,首先要进行深度的自我叩问:平台主要服务于图像识别、自然语言处理还是科学计算?预期的并发训练任务数量是多少?团队的数据科学家与工程师技能栈如何?预算是集中采购还是云上弹性伸缩?回答这些问题,是为整个工程奠定基石的“定盘星”。
一个常见的误区是盲目追求顶尖硬件。对于初创团队或特定垂直场景,有时一台配备高端GPU的工作站或一个云上按需实例,远比自建小型集群来得经济高效。需求锚定的本质,是在性能、成本、复杂度与未来发展之间找到最佳平衡点。这个阶段需要业务、算法与运维团队的紧密碰撞,形成一份包含技术指标、非功能性需求与阶段目标的清晰文档,它是后续所有决策的“宪法”。
忽视战略规划,直接跳入具体实施,往往导致平台建成后与业务需求“水土不服”,造成资源的巨大浪费与团队士气的挫伤。花足够时间进行多维度的需求调研与场景推演,是确保平台价值最大化的首要AI训练平台的搭建方法。
基础设施与资源选型
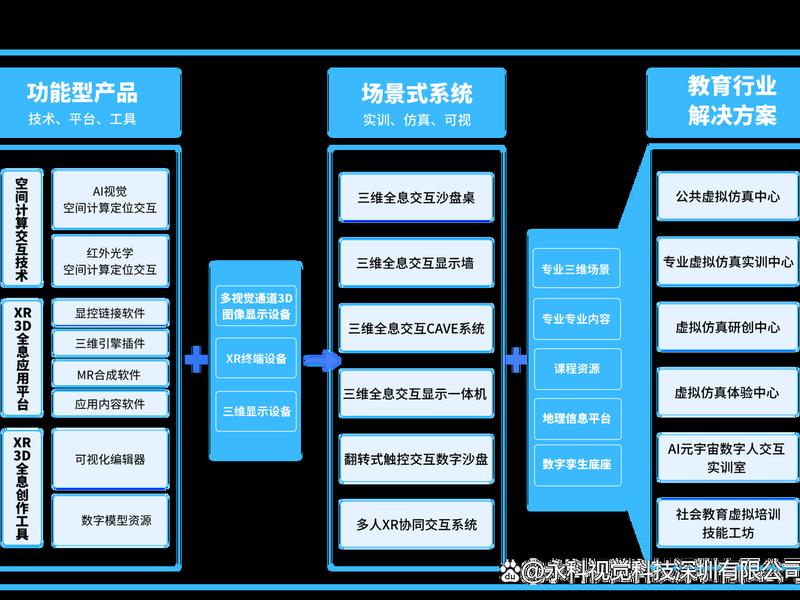
当战略明确后,便进入充满选择的“装备库”。基础设施是平台的骨骼与肌肉。核心抉择在于:私有化、公有云还是混合云?私有化部署能提供极致的数据安全与控制权,但需要高昂的初期投入与专业的运维团队。公有云提供了近乎无限的弹性算力和丰富的托管服务,大幅降低了启动门槛,是快速验证想法的不二之选。
硬件选型是另一个关键战场。GPU无疑是当前AI训练的绝对主力,但面对NVIDIA、AMD以及众多国产AI芯片的“诸神之战”,如何选择?需综合考量算力(TFLOPS)、显存容量与带宽、互联技术(如NVLink)以及对框架和模型的支持程度。CPU、内存、存储(高速SSD或并行文件系统)和网络(InfiniBand或高速以太网)的协同配置,如同精密仪器的齿轮,任何短板都可能成为性能瓶颈。
存储与数据管道是常被低估的“生命线”。训练平台需要吞吐量极高的数据供给。设计一个高效的数据湖或数据仓库,实现从原始数据清洗、标注、版本管理到高速加载至计算节点的无缝流水线,是保证GPU“吃饱吃好”、不被闲置的核心。这一层的稳健与否,直接决定了整个平台的训练效率天花板。
核心软件栈与框架集成
硬件之上,是赋予平台灵魂的软件栈。操作系统层面,Linux(尤其是Ubuntu或CentOS系列)因其强大的稳定性和丰富的生态成为首选。容器化技术,特别是Docker,是实现环境隔离、依赖管理和应用封装的标准武器,它能确保训练任务在任何地方都能以一致的方式运行。
而容器编排的王者Kubernetes(K8s),则是管理大规模训练任务、实现资源调度与自动伸缩的“大脑”。通过K8s,你可以像部署普通应用一样部署分布式训练任务,轻松管理成千上万个容器实例,实现计算资源的精细化利用。在此基础上,专为AI场景优化的KubeFlow或自研调度器,能进一步简化分布式训练(如PyTorch DDP、TensorFlow MultiWorkerMirroredStrategy)的部署与管理。
深度学习框架是算法工程师手中的“手术刀”。平台必须无缝支持主流框架如PyTorch、TensorFlow、JAX及其庞大的生态系统。这不仅仅意味着安装这些库,更需要提供对应的镜像、版本管理工具,并优化其与底层硬件的驱动兼容性。一个优秀的平台,能让研究员只需关注模型与算法,而无需担忧环境冲突与依赖地狱。
平台管理与效能工具
一个现代化的平台,绝不仅仅是资源的堆砌,更是体验与效率的艺术。用户门户与作业提交系统是面向用户的“脸面”。一个友好的Web界面或命令行工具,能让用户轻松提交训练脚本、选择资源规格(GPU数量、内存等)、设置运行参数,并实时查看任务队列状态。
监控与可观测性是平台的“神经系统”。你需要对集群的全局资源利用率(GPU、CPU、内存)、节点健康状态、训练任务的实时指标(如Loss曲线、准确率、吞吐量)进行全方位的监控与告警。使用Prometheus、Grafana等工具构建仪表盘,能让你对平台运行状况了如指掌,快速定位性能瓶颈或故障节点。
实验跟踪与模型管理是AI研发的“核心记忆”。工具如MLflow、Weights & Biases(W&B)或自建系统,能够自动记录每一次实验的超参数、代码版本、指标结果和产出模型,实现实验的完全复现与对比分析。结合模型注册表,可以对模型生命周期进行系统化管理,从训练完成、评估验证到部署上线,形成闭环。这些工具极大地提升了团队协作效率和科研成果的沉淀能力。
安全、成本与持续运维
当平台平稳运行,安全和成本便成为永恒的主题。安全是多层次的:网络安全(防火墙、VPC隔离)、数据安全(传输加密、静态加密、访问控制)、镜像安全(漏洞扫描)以及模型安全(防止对抗攻击、数据泄露)。必须建立从基础设施到应用层的纵深防御体系,尤其在处理敏感数据时。
成本优化是一场永无止境的“”。在云上,利用Spot实例(抢占式实例)、自动伸缩组、资源调度优化(Binpacking等算法)可以大幅降低计算成本。在私有集群中,则需通过提高资源利用率、错峰调度任务、采购性价比更高的硬件来优化TCO(总拥有成本)。建立清晰的成本分摊与Showback机制,能让业务方更负责地使用资源。
没有一劳永逸的平台,持续迭代与运维是它的宿命。建立完善的CI/CD流水线,实现平台组件与用户环境的自动化测试与部署。制定详细的灾难恢复(DR)计划与日常备份策略。培养或拥有一个既懂AI又懂分布式系统和运维的复合型团队,是平台长期健康运行的最终保障。运维的终极目标,是让平台本身“隐身”,让创新自由涌现。
铸就智能基石,启航未来征途
回顾AI训练平台的搭建全景,它绝非简单的软硬件拼装,而是一项融合了战略眼光、技术深度与工程艺术的系统工程。从最初的需求锚定,到基础设施的慎重选型,再到核心软件栈的灵活集成,以及贯穿始终的平台化管理与效能工具赋能,最后落脚于安全、成本与运维的长期主义,每一个环节都至关重要。
本文阐述的AI训练平台的搭建方法,旨在提供一条从混沌到有序的清晰路径。它提醒我们,成功的平台不在于拥有最炫酷的技术,而在于最贴合业务需求的平衡设计,在于能为算法工程师持续、稳定、高效地释放创造力提供支撑。这座“智能工厂”的建成,意味着你将拥有将数据转化为智能的自主生产能力,从而在AI驱动的未来竞争中,掌握核心的主动权。现在,蓝图已然展开,是时候动手,铸造属于你自己的智能基石了。
以上是关于ai训练平台的搭建;ai训练平台的搭建方法的介绍,希望对想了解建站百科知识的朋友们有所帮助。
本文标题:ai训练平台的搭建;ai训练平台的搭建方法;本文链接:https://zwz66.cn/jianz/386358.html。
猜你喜欢
- ai营销系统软件 - ai营销系统软件哪个好 2026-10-23
- ai营销系统指南,ai营销系统指南pdf 2026-10-23
- AI营销源码搭建体验;ai营销源码搭建体验 2026-10-23
- ai自用平台怎么搭建(ai自用平台怎么搭建网站) 2026-10-23
- ai自己生成网站;ai自己生成网站的软件 2026-10-23
- ai自动生成代码网站 - ai自动生成代码网站有哪些 2026-10-23
- ai自动生成代码的软件 - ai自动生成代码的软件下载 2026-10-23
- ai自动生成ppt的网站免费,ai自动生成ppt的网站免费有哪些 2026-10-23
- ai网站维护 - ai官方网站 2026-10-23
- ai网站导航官网(ai网站导航官网首页) 2026-10-23