ai工作站、AI工作站显存与内存容量关系
-
工作站,、,显存,与,内存,容量,关系,在,智能,

- 建站百科知识-小虎建站百科知识网
- 2026-10-23 05:09
- 小虎建站百科知识网
ai工作站、AI工作站显存与内存容量关系 ,对于想了解建站百科知识的朋友们来说,ai工作站、AI工作站显存与内存容量关系是一个非常想了解的问题,下面小编就带领大家看看这个问题。
在智能浪潮席卷千行百业的今天,AI工作站已不再是科幻电影里的冰冷机器,而是驱动创新、孵化未来的核心引擎。当我们将目光聚焦于其澎湃的算力心脏——GPU时,两个至关重要的参数总会跃入眼帘:显存与内存。它们如同雄鹰的双翼,任何一侧的失衡都可能导致算力无法展翅高飞。显存,是GPU的专属高速战场,直接决定了能承载多大的模型与多复杂的计算;内存,则是CPU统御下的广阔后方,负责调度所有任务与数据。二者的容量关系,绝非简单的数字堆砌,而是一场精妙的协同博弈,直接定义了AI工作站的潜力边界与应用疆域。理解这场“容量之舞”,是驾驭AI生产力、避免资源瓶颈的关键一步。
算力心脏的双重血脉
如果将AI工作站比作一位进行高强度脑力劳动的智者,那么GPU便是其进行核心逻辑推理与创造性思维的“大脑皮层”,而CPU则是统筹协调全身机能的“神经中枢”。在这个精妙的比喻下,显存(VRAM)就如同大脑皮层中高速运作的短期工作记忆区。当智者处理一个复杂的数学证明或构思一幅宏大的画作时,所有正在被直接运算的公式、线条与色彩,都必须即时存在于这个工作区中。它的容量与速度,直接决定了思维能同时处理的信息复杂度和规模。一旦证明过程过长或画布过于宏大,超出了工作区的承载极限,思维就会陷入卡顿,不得不将部分内容暂时“寄存”到别处,导致效率急剧下降。
与此相对,系统内存(RAM)则更像是智者书房中那庞大的书架与资料库,储存着完成这项智力活动可能需要的所有参考书籍、历史笔记和待处理的原始素材。CPU这个“神经中枢”负责从这些书架(内存)中,将当前需要用到的部分资料,快速搬运到“大脑皮层”(GPU显存)的工作区中进行处理。内存的容量,决定了智者的“知识储备”和“待办事项”的规模上限。一个狭小的书房,无法容纳浩如烟海的文献,自然也限制了智者所能涉足课题的广度与深度。
由此可见,显存与内存,构成了AI算力输出的双重血脉。显存是前沿阵地的实时补给线,内存是战略纵深的资源储备库。二者并非孤立存在,而是通过PCIe通道这座“高速公路”紧密相连,进行着高速的数据交换。任何一方的容量短板,都会成为这条数据流的“栓塞点”,让强大的计算核心陷入“巧妇难为无米之炊”或“粮草堆积却运不上前线”的尴尬境地。理解它们各自扮演的角色,是优化AI工作站配置的认知基石。
显存容量:模型载体的绝对尺度
在AI深度学习的世界里,模型就是上的明珠。而显存容量,则是决定这颗明珠能否被顺利托起、并璀璨绽放的“手掌”大小。无论是训练一个识别疾病的医疗影像模型,还是驱动一个生成逼真画面的扩散模型,模型的参数、每一批训练数据(batch size)、以及计算过程中的中间激活值,都需要被完整地加载到GPU显存中。这就像一个巨型工厂的生产线,原材料(数据)、机器模具(模型参数)和半成品(激活值)必须同时放置在车间(显存)里,流水线才能开动。
当模型规模膨胀,例如从数亿参数的BERT发展到千亿参数的GPT时,对显存的需求是指数级增长的。显存容量直接划定了能力的红线。容量不足,工程师就不得不采取“拆解”策略:例如使用更小的批次大小,这如同让工厂每次只加工一点点原料,严重拖慢训练速度;或者采用模型并行、梯度累积等复杂技术,相当于把一条生产线拆成几段放在不同车间,增加了协调复杂度与通信开销。更极端的情况下,模型根本无法加载,所有算力都沦为摆设。
对于专注于大模型训练、高分辨率图像渲染或科学仿真的高端AI工作站而言,大容量显存(如24GB、48GB甚至更多)不仅是“锦上添花”,更是“生死攸关”。它提供了直接处理庞然大物的自由,避免了因容量限制而引入的额外复杂性和性能损耗。可以说,显存容量定义了AI工作站所能触碰的模型世界的“天花板”高度,是衡量其解决核心AI问题能力的第一把标尺。
内存容量:数据洪流的缓冲港湾
如果说显存是精炼核心算法的“反应釜”,那么内存就是汇聚原始数据“江河湖海”的超级水库。在典型的AI工作流程中,原始数据集往往非常庞大,以TB计的数据无法、也不应全部一次性塞进显存。大容量内存就扮演了至关重要的“缓冲池”和“调度中心”角色。数据集首先被加载到内存中,然后由CPU和软件框架进行预处理(如清洗、增强、分批),再以稳定的流速将一个个“数据批次”通过PCIe通道输送给GPU显存进行训练。
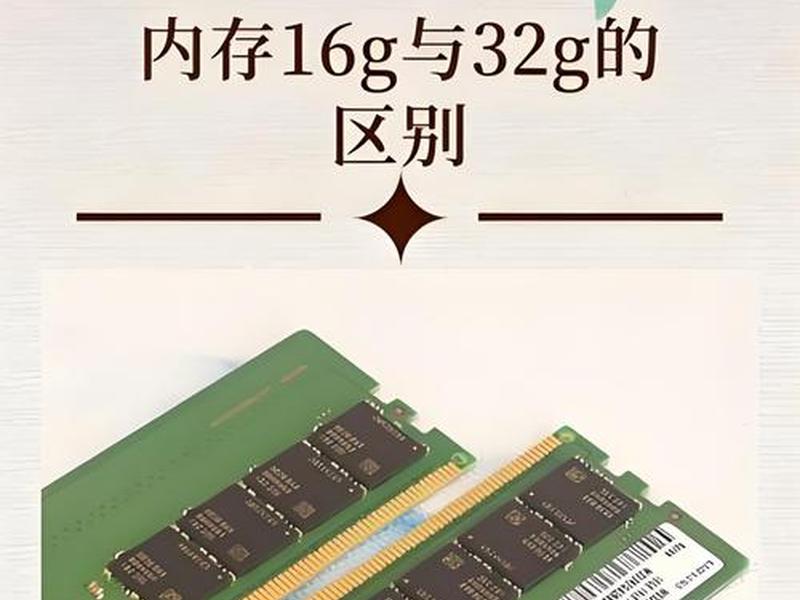
内存容量的大小,直接决定了这个“缓冲池”的规模。容量越大,能够暂存和预处理的数据就越多,越能保证向GPU供应数据的“管道”持续饱满,避免因数据I/O等待而导致GPU算力闲置——这种现象被称为“数据瓶颈”。例如,在处理长达数小时的高清视频素材进行AI分析时,或是在管理数千万条文本语料进行自然语言处理时,充足的内存能够确保海量数据被高效组织、快速访问,从而让GPU始终处于“吃饱”的忙碌状态。
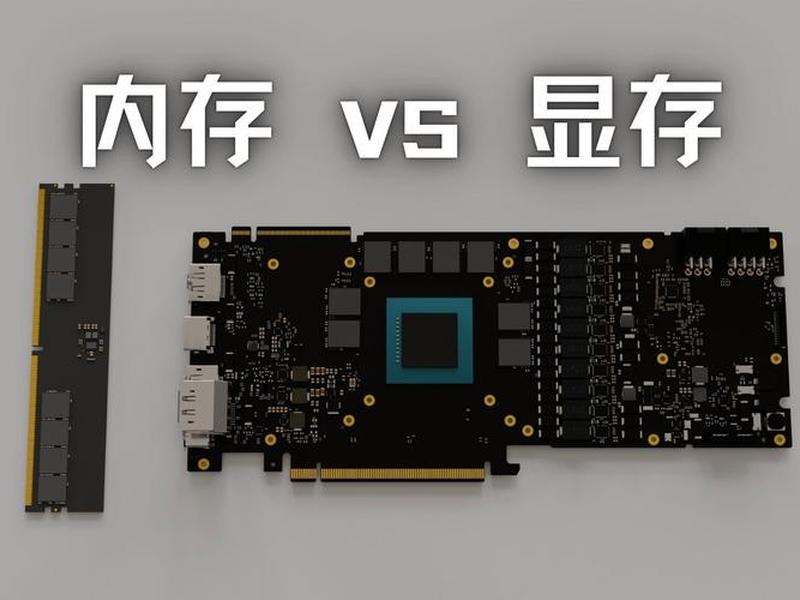
现代AI工作站往往需要多任务并行。研究者可能一边训练模型,一边运行数据预处理脚本,同时还开着多个分析工具和开发环境。所有这些进程都会占用内存。如果内存不足,系统就会开始使用速度慢上千倍的硬盘进行“虚拟内存”交换,导致整体响应速度变得极其缓慢,严重影响工作效率。足够大的内存容量(如64GB、128GB甚至更高),不仅是应对单一大型数据集的需要,更是保障AI工作站多任务流畅运行、维持高效创作与研究节奏的基础设施。
容量配比的黄金法则
既然显存和内存都至关重要,那么在实际配置AI工作站时,是否存在一个“黄金比例”?答案是:它并非一个固定公式,而是一条动态平衡的艺术。其核心法则在于“匹配工作负载”。配置的出发点必须是目标应用场景,而非盲目追求单项参数的极致。
对于模型训练与推理导向型工作站,尤其是涉及大型神经网络(LLM、扩散模型等),配置应显著向显存倾斜。原则是:显存容量必须优先满足能将目标模型及合理批次数据装入其中。例如,训练一个需要20GB显存的模型,那么选择24GB显存的GPU就是合理底线。在此基础上,内存容量通常建议为显存总量的2-4倍或更多,以确保有足够空间存放庞大的训练集和进行高效的数据流水线作业。一个常见的搭配可能是:一块48GB显存的GPU,配以128GB或256GB的内存。
对于数据科学与分析导向型工作站,其特点可能是处理巨量表格数据、进行复杂的特征工程或运行大规模模拟。这类任务有时更依赖CPU的多核并行能力和内存的吞吐量,GPU加速可能用于特定计算库(如cuDF)。内存容量成为更关键的资源,可能需要512GB甚至更高,以将整个数据集放入内存进行快速操作。显存容量则可以相对适度,例如16GB或24GB,主要用于加速部分矩阵运算。
对于内容创作与多任务混合型工作站(如AI绘画、视频特效、同时进行开发与渲染),则需要均衡考虑。足够的内存(32GB-64GB起步)保障多软件流畅运行,而足够的显存(12GB以上)则确保AI渲染插件和GPU加速效果能实时预览。避免“木桶效应”,找到两者之间与预算平衡的那个“甜蜜点”,是配置的核心智慧。
未来演进与配置前瞻
AI技术的狂飙突进,正在不断重塑着对显存与内存的需求图谱。模型规模的膨胀似乎没有尽头,多模态大模型需要同时处理文本、图像、音频,对显存带宽和容量提出双重挑战。数据处理流程日益复杂,实时学习、持续训练等范式要求内存能承载不断流动和增长的数据流。
技术层面,两大趋势正在改写规则。一是显存技术的革新,如HBM(高带宽内存)的普及,它在提供巨大容量的带来了惊人的带宽,极大缓解了数据吞吐瓶颈。未来的AI工作站GPU,高容量HBM将成为高端标配。二是内存与显存界限的模糊,如NVIDIA的CUDA Unified Memory和AMD的Infinity Cache等技术,试图在硬件和软件层面创建更统一的地址空间,让数据流动更为智能,减轻程序员手动管理数据的负担。但这并不意味着两者可以相互替代,专精化设计在可预见的未来仍将存在。
面对未来,配置AI工作站需要更具前瞻性。对于企业和高阶研究者,为显存和内存预留充足的升级空间(如选择支持多GPU、多内存通道的主板)至关重要。在预算范围内,应优先投资于无法后期轻松升级的组件——通常是GPU及其显存。内存虽可增补,但初期配置也应一步到位,避免频繁升级的麻烦。理解当前项目的需求,并预判未来半年到一年的技术演进,才能在容量博弈中做出明智抉择,让AI工作站不仅满足当下,更能拥抱即将到来的算力浪潮。
协同共舞,方显智能本色
回顾这场关于AI工作站显存与内存的容量探秘,我们可以清晰地看到,它们绝非简单的存储单元,而是塑造智能生产力的两大支柱。显存是GPU施展魔法的即时舞台,其容量直接决定了能上演多么宏伟的模型戏剧;内存则是支撑整个创作生态的后台与仓库,其广度确保了数据洪流能有序汇入计算核心。二者的关系,是精密的协同,是动态的平衡,是面向具体工作负载的深度定制。
忽略显存,再强大的算力核心也无用武之地;轻视内存,再高效的数据处理流程也会陷入泥潭。一台真正强大的AI工作站,必然是显存与内存根据核心任务达成完美配比的结果。它让研究人员能够将百亿参数模型了然于胸,让艺术家可以挥洒数K分辨率画布而无须等待,让数据分析师能在海量信息中瞬间捕捉洞察。
在这个智能定义未来的时代,理解并驾驭好显存与内存的容量之舞,就意味着掌握了开启更广阔创新大门的钥匙。这不仅是对硬件配置的认知,更是对AI工作流本质的深刻洞察。当双翼丰满,算力雄鹰必将翱翔于更无垠的数据苍穹,探索人类智能边界的下一个奇迹。
以上是关于ai工作站、AI工作站显存与内存容量关系的介绍,希望对想了解建站百科知识的朋友们有所帮助。
本文标题:ai工作站、AI工作站显存与内存容量关系;本文链接:https://zwz66.cn/jianz/386146.html。
猜你喜欢
- ai图片自动生成、ai图片自动生成图片软件 2026-10-23
- ai原创全智能系统、ai原创全智能系统有哪些 2026-10-23
- ai写论文 工具(ai写文章工具) 2026-10-23
- ai公司名称、ai软件开发公司名称 2026-10-23
- ai代码生成器网站、ai代码生成器网站大全 2026-10-23
- ai人工智能网站、ai人工智能产品网站 2026-10-23
- ai一键生成ppt的优质模板、ai一键生成ppt的优质模板在哪 2026-10-23
- ainipa导航、ai 导航 2026-10-23
- ai 导航、百度地图 ai导航 2026-10-23
- abc类加盟条件、abc英语加盟条件 2026-10-23