站源采集 采集站资源
-
站源,采集,站,资源,在,信息,如,汪洋大海,的,

- 建站百科知识-小虎建站百科知识网
- 2026-10-08 06:09
- 小虎建站百科知识网
站源采集 采集站资源 ,对于想了解建站百科知识的朋友们来说,站源采集 采集站资源是一个非常想了解的问题,下面小编就带领大家看看这个问题。
在信息如汪洋大海的数字时代,网站内容的质量与丰富度直接决定了其在互联网浪潮中的沉浮。你是否曾好奇,那些内容浩如烟海、更新迅捷的资讯站、小说站或影视站,其海量信息究竟从何而来?答案,就隐藏在“站源采集”与“采集站资源”这两个看似技术化,实则充满魔力的概念之中。它们如同数字世界的“采矿”与“炼金”术,从广袤的网络矿脉中识别、提取、转化有价值的“矿石”——即文本、图片、音频、视频等资源,进而构筑起一个个内容充实的线上王国。本文将为你揭开这背后的运作逻辑、核心策略与未来图景,探索其如何成为驱动网站生命力与竞争力的隐形心脏。
采集资源的本质与分类
站源采集的核心对象是“采集资源”,它泛指一切可从互联网上获取并用于丰富网站内容的数字化材料。这个过程远非简单的复制粘贴,而是一个系统性的数据治理起点,涉及从非结构化或半结构化的原始数据源中,精准提取并转化为结构化、可用的文本信息。
互联网上的资源如同一个庞大的生态系统,主要可分为三大类。文字图片资源是基石,几乎存在于每一个网站,新闻的即时报道、小说的跌宕情节、摄影艺术的视觉震撼,乃至一个简单的表情包,都依赖于文字与图片的有机结合。它们是构建网站信息骨架的最基本元素。
音频资源则为网络空间增添了旋律与节奏。以音乐为主题的站点是其主要应用场景,一段动感的DJ舞曲或一首深情的民谣,往往伴随着精美的封面图片和详尽的介绍文字,共同构成一个完整的听觉体验单元。这类资源的采集,让网站从沉默的图文世界迈入了有声的多元境界。
视频资源则是最为复杂和丰富的形态。一部电影、一集动漫、一段教学视频,不仅包含动态影像和声音,同样承载着海报、简介、字幕等图文信息。由于播放器技术(如早期流行的百度影音、QVOD,到如今的各大流媒体平台格式)的多样化,视频资源的采集技术也最为纷繁,构成了影视站、动漫站等内容帝国的核心支柱。
采集技术的演进与工具革新
采集技术的历史,是一部从手工劳作走向智能自动化的进化史。回溯至上世纪八九十年代,企业大多依赖人工编写脚本或安排数据库批处理任务来完成零星的数据交换,效率低下且容易出错。随后,第一代专门的数据采集工具——ETL(提取、转换、加载)工具应运而生,标志着数据采集进入了专业化阶段。
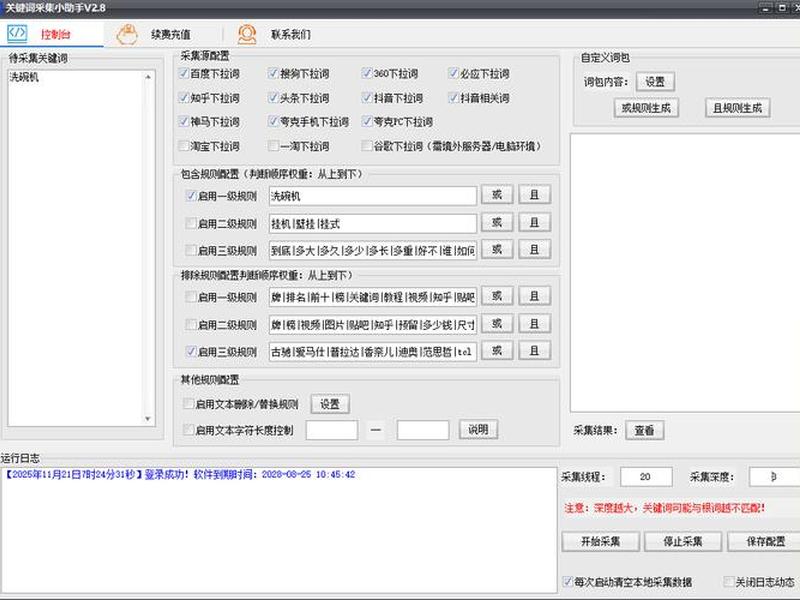
如今,采集技术已迈入可视化、智能化的新时代。新一代采集器软件,如后羿采集器、八爪鱼采集器等,彻底降低了技术门槛。它们提供智能识别与可视化点选配置,用户无需编写一行代码,即可像搭积木一样定义采集规则。这些工具能模拟人类浏览行为,执行点击翻页、输入关键词、滚动加载等复杂操作,高效应对各种动态网页。
技术的核心手段也日趋多元。网络爬虫(蜘蛛程序)能够沿着
以上是关于站源采集 采集站资源的介绍,希望对想了解建站百科知识的朋友们有所帮助。
本文标题:站源采集 采集站资源;本文链接:https://zwz66.cn/jianz/372967.html。
猜你喜欢
- 站点下载,站点下载齐振消费安全警告提示 2026-10-08
- 站桩骨架堆叠要领图解 站桩骨架堆叠要领图解大全 2026-10-08
- 站桩静心简单入门法;站桩静心简单入门法图解 2026-10-08
- 站桩辅助工具、站桩辅助工具有哪些 2026-10-08
- 站桩视频教程站桩音乐;站桩音乐45分钟视频 2026-10-08
- 站桩视频教程直播;站桩视频教程直播在线观看 2026-10-08
- 站桩视频教程新手入门;站桩视频教程新手入门下载 2026-10-08
- 站桩视频教程徐文兵 站桩视频教程徐文兵讲解 2026-10-08
- 站桩视频教程哪个好,站桩的视频初学视频教程 2026-10-08
- 站桩视频教程哪个好、站桩的视频初学视频教程 2026-10-08







