新数据覆盖原有数据方法 新数据覆盖原有数据方法包括
-
新数据,新,数据,覆盖,原有,方法,包括,在,数字,

- 建站百科知识-小虎建站百科知识网
- 2026-10-03 02:29
- 小虎建站百科知识网
新数据覆盖原有数据方法 新数据覆盖原有数据方法包括 ,对于想了解建站百科知识的朋友们来说,新数据覆盖原有数据方法 新数据覆盖原有数据方法包括是一个非常想了解的问题,下面小编就带领大家看看这个问题。
在数字洪流奔涌的时代,数据如同细胞的代谢,新旧更迭是永恒的法则。想象一下,当你的手机存储告急,一张新照片的存入,悄然抹去了某个角落的旧记忆;当电商平台更新你的收货地址,旧信息瞬间被新坐标取代。这,就是数据覆盖——一场发生在比特与字节层面的无声革命。它不仅关乎存储空间的循环利用,更是维系数据库鲜活、确保信息精准的核心机制。理解并掌握新数据覆盖原有数据的方法,意味着你握住了数据管理的钥匙,既能主动驾驭更新,也能有效防范意外丢失。本文将带你深入这片隐秘的领域,从多个维度揭开数据覆盖的层层面纱。
数据更新的主动覆盖
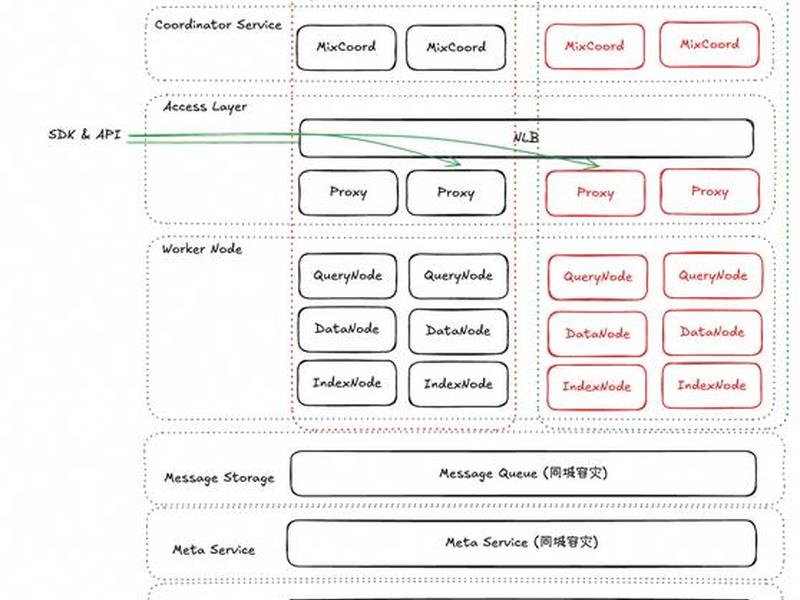
这是数据覆盖中最常见、最直接的方式。在动态系统中,数据更新如同呼吸般自然。当用户修改个人信息、商品调整价格、文章更新内容时,新的数据值便会写入数据库的特定位置,直接取代旧有的记录。
这种覆盖确保了信息的实时性与准确性,是系统保持活力的基础。数据库系统通常会为此类操作设计高效的执行路径,并记录日志,以便在必要时追溯变更轨迹。主动覆盖是业务运转的常态,它要求系统具备强大的并发处理能力和事务完整性保障,以防更新过程中的数据错乱。
便利的背后也潜藏风险。一次错误的更新操作,可能导致关键历史数据被不可逆地覆盖。在重要的业务系统中,往往需要辅以版本控制或变更审计,为数据的“新陈代谢”加上一道安全阀。
冲突解决下的强制覆盖
在多用户或分布式环境中,数据覆盖常伴随冲突而来。当多个进程或用户同时试图修改同一数据对象时,系统必须做出裁决。悲观锁通过提前独占资源来避免冲突,而乐观锁则允许多方读取,仅在提交时检查版本,若发现冲突,后提交的操作往往会覆盖先前的更改。
这种覆盖是维持数据一致性的关键手段。在金融交易、库存管理等场景中,它防止了数据因并发操作而陷入矛盾状态。系统依据预设的规则(如时间戳、版本号)来决定哪一方的新数据最终胜出,完成覆盖。
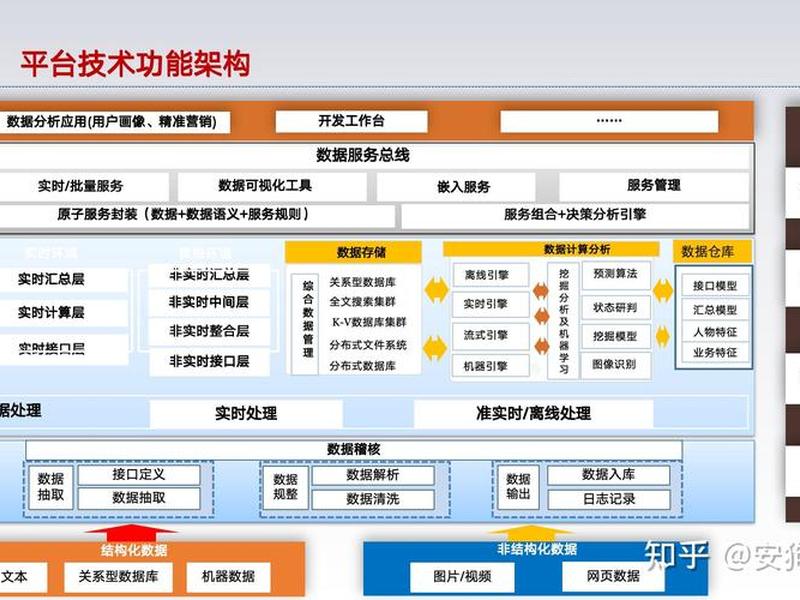
冲突覆盖机制的设计极为精妙,需要在数据一致性与系统高并发性能之间找到平衡点。过于严格的锁会导致性能瓶颈,过于宽松的策略又可能产生脏数据。理解其原理,对于构建稳健的高并发应用至关重要。
存储介质的物理覆盖
在硬盘、固态硬盘(SSD)、U盘等物理存储设备上,数据覆盖是一个底层过程。当你删除一个文件,操作系统通常只是标记其占用空间为“可重用”,而非真正擦除。只有当新的文件写入并占用同一物理扇区时,旧数据才被实质覆盖,变得难以恢复。
这一特性催生了数据安全领域的重要实践——安全擦除。为了彻底防止敏感信息被恢复,会采用多次覆盖(如用全0、全1、随机数反复写入)的方法,彻底扰乱原有的磁记录或电荷状态,这便是著名的“三级覆盖法”原理。
对于个人用户,在处理废旧手机、硬盘时,简单的恢复出厂设置或格式化并不保险。采用专业的覆盖工具进行多次擦写,才能有效防止隐私数据在设备流转中被恶意复原,这是数字时代必备的安全素养。
数据库指令的批量覆盖
在数据库管理中,存在专门用于批量覆盖的高级操作指令。例如,MySQL中的 `REPLACE INTO` 语句,或在存在唯一键冲突时使用的 `INSERT ... ON DUPLICATE KEY UPDATE` 语句。它们允许开发者用一条命令完成“存在则更新(覆盖),不存在则插入”的逻辑。
这类方法极大简化了数据处理流程,特别适用于数据同步、批量导入等场景。它避免了繁琐的“先查询判断是否存在,再决定更新或插入”的操作,提升了效率。其副作用也需警惕,如 `REPLACE` 语句实质是先删除再插入,可能意外触发关联的删除触发器或外键约束。
熟练掌握这些指令,犹如掌握了数据库的“魔法”,能优雅地处理大量数据的合并与更新。但使用时必须清晰理解其底层行为,并在测试环境中充分验证,避免对生产数据造成意料之外的覆盖损失。
系统恢复与备份覆盖
当系统崩溃或数据损坏时,从备份中恢复数据是最后的救命稻草。这个过程本质上是将备份集中的数据覆盖到现有的、可能已损坏的数据库或文件系统上。它用一份过去的、完好的数据副本,强行替换当前状态。
这种覆盖是数据灾难恢复的核心环节。其有效性高度依赖于备份策略的健全性——备份是否够新、是否完整。增量备份与差异备份能在覆盖时提供更精细的恢复点选择。恢复性覆盖是一把双刃剑,它可能用旧数据覆盖掉崩溃后产生的有效新数据,因此恢复点的选择需要极其审慎。
完善的备份覆盖策略,必须与事务日志相结合。通过“完整备份+日志回放”,可以精准地将数据库恢复到故障前的最后一秒,最大化减少数据损失,实现覆盖与保留的艺术平衡。
同步机制中的覆盖传播
在分布式系统、云同步或边缘计算节点间,数据同步是维持全局一致性的纽带。主节点更新的数据,会作为新数据覆盖到各个从节点或同步端。这种覆盖可能通过定时任务或实时推送完成,确保所有节点最终持有相同的数据视图。
同步覆盖构建了可扩展的现代应用架构,但也引入了复杂性。网络延迟或分区可能导致不同节点短暂持有不同版本的数据(冲突)。先进的系统会采用冲突解决算法,如“最后写入获胜”或基于业务逻辑的自动合并,来决定最终哪个版本覆盖其他版本。
理解同步覆盖的机制,对于设计跨地域、高可用的服务至关重要。它要求开发者不仅关注数据本身,还要关注数据流动的路径、时序以及冲突发生时的处理策略,确保覆盖行为最终导向一致而非混乱。
以上是关于新数据覆盖原有数据方法 新数据覆盖原有数据方法包括的介绍,希望对想了解建站百科知识的朋友们有所帮助。
本文标题:新数据覆盖原有数据方法 新数据覆盖原有数据方法包括;本文链接:https://zwz66.cn/jianz/367294.html。
猜你喜欢
- 新柴服务站建站要求 - 新柴发动机售后服务站电话 2026-10-03
- 新数据获客 - 大数据获客是什么 2026-10-03
- 新数据怎么导入折线图 - 新数据怎么导入折线图的数据 2026-10-03
- 新数据建站教程 搭建数据库网站 2026-10-03
- 新数据如何覆盖旧数据 新数据如何覆盖旧数据库 2026-10-03
- 新数据中心建设原视频 - 新数据中心建设汇报ppt 2026-10-03
- 新抖数据平台使用案例分享 - 新抖数据平台怎么用 2026-10-03
- 新抖数据平台使用教程 新抖数据平台怎么用 2026-10-03
- 新手零成本建站,新手建站用哪里的服务器好 2026-10-03
- 新手零基础搭建小程序 - 新手零基础搭建小程序怎么做 2026-10-03







