数据库建立;数据库建立索引
-
数据库,建立,索引,在,数字,世界,的,深处,每一,

- 建站百科知识-小虎建站百科知识网
- 2026-10-02 12:10
- 小虎建站百科知识网
数据库建立;数据库建立索引 ,对于想了解建站百科知识的朋友们来说,数据库建立;数据库建立索引是一个非常想了解的问题,下面小编就带领大家看看这个问题。
在数字世界的深处,每一款应用、每一次点击、每一条记录的背后,都矗立着一座无形的“数据神殿”——数据库。它如同数字文明的地基,默默承载着信息的洪流。仅仅建立起这座神殿还远远不够。试想,一座藏书亿万却杂乱无章、寻一本书需遍历所有书架的巨大图书馆,其效率何其低下?这正是没有索引的数据库所面临的困境。数据库的建立,是构筑坚实的地基;而索引的创建,则是铺设通往数据宝藏的高速通道。本文将带你深入探索从蓝图规划到性能飞越的完整旅程,揭开构建高效、健壮数据系统的核心奥秘。
一、蓝图规划:需求分析与结构设计
任何伟大的建筑都始于一张精确的蓝图,数据库的建立亦是如此。这一步远非简单的建表,而是一次深刻的业务洞察与数据抽象。你需要像侦探一样,与业务方深入沟通,理解数据从哪里来、到哪里去、如何被使用。是记录用户交易的订单系统,还是分析用户行为的大数据平台?不同的用途决定了截然不同的设计哲学。
在纸上或设计工具中,清晰地写下数据库的使命宣言。例如,“库用于存储,以支持精准营销、生成报表和提升服务质量”。这份声明将成为后续所有决策的灯塔,确保设计不偏离核心目标。接着,开始收集和组织所需的信息实体:客户、订单、产品……并梳理它们之间的关系。关键在于将信息分解到合适的粒度,例如,将客户姓名拆分为“姓”和“名”,将地址拆分为省、市、街道等独立字段。这种范式化的设计,为未来的排序、筛选和高效查询埋下了伏笔。
记住,在此阶段应避免存储可直接计算得出的数据。例如,订单总价可以通过单价乘以数量实时计算,无需作为一个固定字段存储。这遵循了数据库设计的一条重要原则:减少数据冗余,保证单一数据来源,从而从根本上维护数据的一致性。蓝图规划的质量,直接决定了未来系统是优雅灵活,还是臃肿难改。
二、核心构建:表结构设计与关系建模
有了清晰的蓝图,接下来便是用砖石——表(Table)和列(Column)——搭建主体结构。这一阶段的核心是将现实世界的实体和关系,转化为数据库能理解的语言。你需要决定每个实体对应哪张表,每个属性对应哪个字段,并精心选择数据类型:是用整数存储ID,用变长字符串存储姓名,还是用日期时间类型记录时刻?
更为精妙的是定义表与表之间的关系。主要通过主键和外键来实现。主键是表中每条记录的唯一标识,如同公民的身份证号;外键则指向另一张表的主键,用以建立关联。例如,“订单”表中会有一个“客户ID”字段作为外键,指向“客户”表的主键,从而明确每笔订单属于哪位客户。这种关系建模,确保了数据的完整性和关联查询的可能性。
ER图(实体-关系图)和数据字典成为不可或缺的工具。ER图直观地展示了表之间的网络,数据字典则详细说明了每个字段的含义、类型和约束。它们不仅是开发者的路线图,也是后来维护者理解系统设计的钥匙。一个设计良好的表结构,应该既能满足当前所有查询需求,又具备一定的扩展性以应对未来变化。
三、性能灵魂:索引的创建策略与类型选择
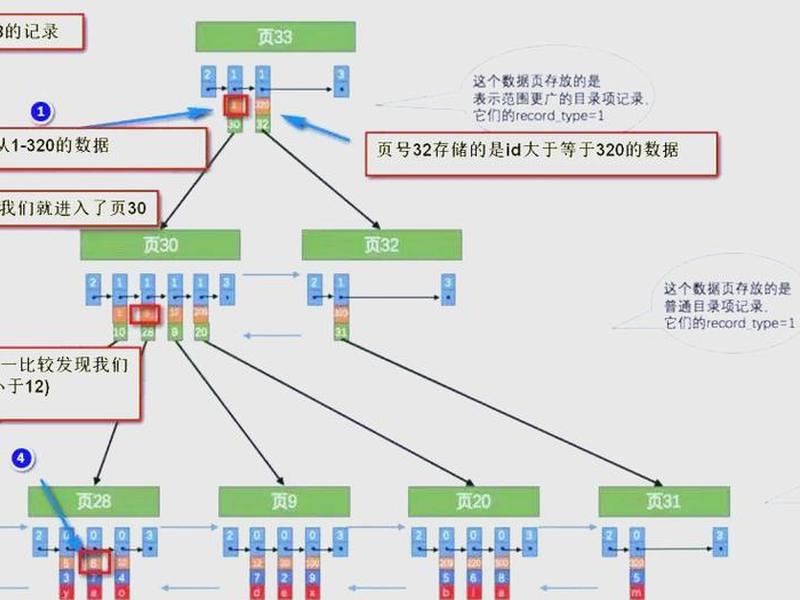
当数据海量涌入,高效的检索便成为生死攸关的问题。索引应运而生,它就像图书馆的目录或书籍的索引页,允许数据库引擎绕过全表扫描,直接定位到所需数据行。索引绝非越多越好。每创建一个索引,都需要额外的存储空间,更关键的是,会在数据插入、更新和删除时带来维护开销,因为索引树结构也需要同步调整。
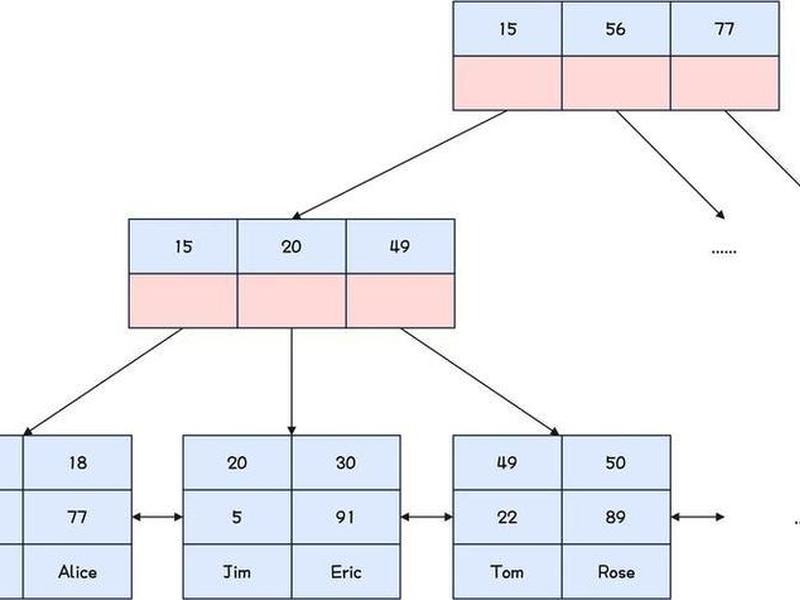
索引类型的选择是一门艺术。最常见的B-Tree索引适用于范围查询和排序操作;哈希索引则对等值查询速度极快,但不支持范围查询;对于文本内容的模糊搜索,需要用到全文索引;而处理地理空间数据,则需依赖空间索引。例如,在电商场景中,为“用户ID”、“订单状态”、“创建时间”创建一个复合索引,可以极快地响应用户查询自己特定状态订单列表的需求。
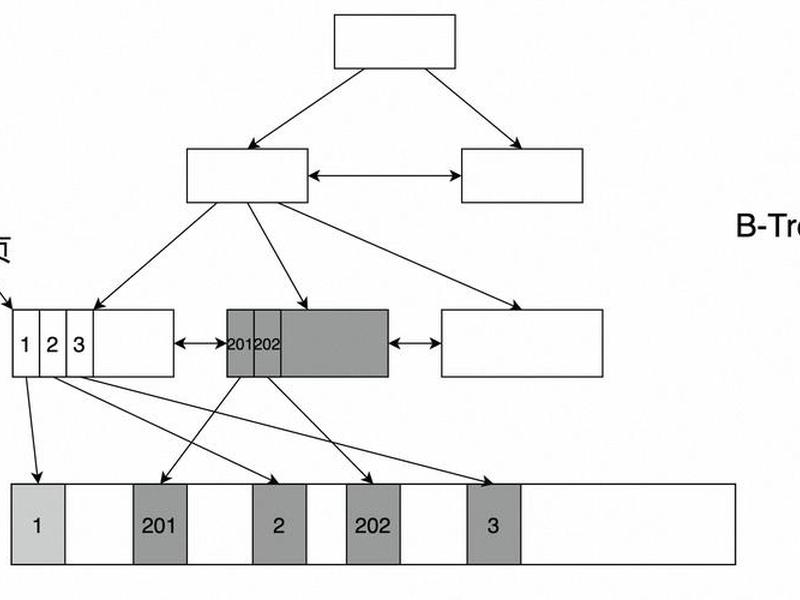
创建索引的核心原则是“有的放矢”。应优先考虑在`WHERE`子句、`JOIN`条件以及`ORDER BY`子句中高频出现的字段上建立索引。注意“最左前缀”原则:对于复合索引`(A, B, C)`,查询条件仅包含`B`和`C`时将无法有效利用该索引。索引是典型的“空间换时间”策略,其设计与应用直接决定了数据库的响应速度与用户体验。
四、避坑指南:索引失效场景与维护要点
即使创建了索引,也未必能一劳永逸。许多看似平常的操作会导致索引“失效”,使查询被迫退回低效的全表扫描。常见的陷阱包括:在索引列上使用函数或进行计算(如`WHERE YEAR(create_time)=2023`);进行隐式的数据类型转换(如字符串字段与数字比较);以及不符合最左前缀原则的复合索引使用。
索引也需要悉心维护。随着数据的增删改,索引会产生碎片,降低查询效率。定期重建或重新组织索引是必要的维护操作。数据库的查询优化器依赖于统计信息来选择使用哪个索引。如果统计信息过时,优化器可能做出错误判断。定期更新表统计信息(如使用`ANALYZE TABLE`)至关重要,这能使优化器选择正确索引的概率大幅提升。
更需要警惕的是“过度索引”的陷阱。一个表中堆积了过多未经验证的索引,尤其是在更新频繁的表上,会严重拖慢写入速度,并占用大量存储空间。通过数据库提供的性能监控工具,定期分析索引的使用情况,清理那些从未或极少被使用的“僵尸索引”,往往能释放巨大的性能潜力,实现读写效率的双重提升。
五、高阶优化:执行计划分析与复合策略
要真正驾驭索引,必须学会与数据库优化器对话,而对话的工具就是“执行计划”。通过`EXPLAIN`命令查看SQL语句的执行计划,你可以清晰地看到数据库准备如何执行这条查询:它选择了哪个索引?预计要扫描多少行数据?是否需要额外的排序操作?关注“type”列(访问类型)、`rows`列(扫描行数)和`Extra`列(额外信息),能精准定位性能瓶颈。
基于执行计划的分析,可以实施更精细的优化策略。例如,创建“覆盖索引”,使索引本身包含查询所需的所有列,这样数据库引擎只需访问索引即可返回结果,无需回表查询数据行,能极大减少I/O操作。又如,针对热点查询,可以设计专门的复合索引,其列的顺序完全匹配查询条件、排序和分组的需求。
在高并发、大数据量的生产环境中,索引优化往往需要结合分区、缓存、读写分离等策略形成组合拳。例如,对按时间范围查询的历史数据表进行分区,并在每个分区上建立合适的索引,可以同时提升查询和维护效率。记住,优化是一个持续迭代的过程,需要随着业务增长和数据变化不断调整。
以上是关于数据库建立;数据库建立索引的介绍,希望对想了解建站百科知识的朋友们有所帮助。
本文标题:数据库建立;数据库建立索引;本文链接:https://zwz66.cn/jianz/366626.html。
猜你喜欢
- 数据库建站之星教程(建站怎样才能找到数据库) 2026-10-02
- 数据库建立用什么软件、数据库建立用什么软件好 2026-10-02
- 数据库建立步骤(数据库建立步骤是什么) 2026-10-02
- 数据库建立服务、数据库服务器的连接及数据库的建立 2026-10-02
- 数据库建立教程视频 数据库建立教程视频讲解 2026-10-02
- 数据库建立怎么操作(数据库建立怎么操作的) 2026-10-02
- 数据库建模(数据库建模是什么意思) 2026-10-02
- 数据库建库,数据库建库步骤 2026-10-02
- 数据库建库详细流程,数据库建库详细流程包括 2026-10-02
- 数据库建库步骤,数据库建库步骤有哪些 2026-10-02







