怎么爬网站php脚本;怎么爬网站php脚本教程
-
怎么,爬,网站,php,脚本,教程,你,是否,曾对,

- 建站百科知识-小虎建站百科知识网
- 2026-09-30 17:48
- 小虎建站百科知识网
怎么爬网站php脚本;怎么爬网站php脚本教程 ,对于想了解建站百科知识的朋友们来说,怎么爬网站php脚本;怎么爬网站php脚本教程是一个非常想了解的问题,下面小编就带领大家看看这个问题。
你是否曾对网络上浩瀚的数据海洋望洋兴叹,渴望拥有一种魔法,能自动抓取所需信息,化为己用?这种魔法并非幻想,它正是网络爬虫。而PHP,这门强大的服务器端脚本语言,正是铸造这把“数据之钥”的绝佳材料。本文将为你揭开“怎么爬网站php脚本”的神秘面纱,提供一套从零到精通的实战教程,不仅教你编写高效的爬虫脚本,更分享让文章在百度搜索中脱颖而出的核心SEO策略,助你打造一篇既能传授真知,又能轻松斩获排名第一的终极指南。
理解爬虫的核心原理
网络爬虫,本质上是一个自动化浏览网页并提取数据的程序。它的工作流程如同一只不知疲倦的电子蜘蛛,在互联网这张大网上按照既定规则穿梭。它会从一个或一组初始网址出发,向目标服务器发送HTTP请求。服务器响应后,返回网页的HTML源代码,这就像获取了一本书的原始手稿。
接下来,爬虫需要扮演“信息提炼师”的角色。它必须解析这份充满标签和代码的HTML文档,从中精准定位并抓取你感兴趣的内容,可能是文章标题、商品价格、图片链接,或是隐藏在JavaScript动态加载背后的数据。PHP提供了多种强大的工具来完成这一步,例如结合正则表达式进行模式匹配,或使用DOMDocument、SimpleHTMLDom等解析库进行结构化提取。
爬虫需要将提炼出的宝贵数据妥善保存。无论是存入MySQL数据库形成结构化档案,还是输出为CSV、JSON文件方便交换,亦或是直接展示在网页上,PHP都能轻松胜任。理解了这个“请求-解析-存储”的核心循环,你就掌握了爬虫的灵魂,为编写脚本奠定了坚实的理论基础。
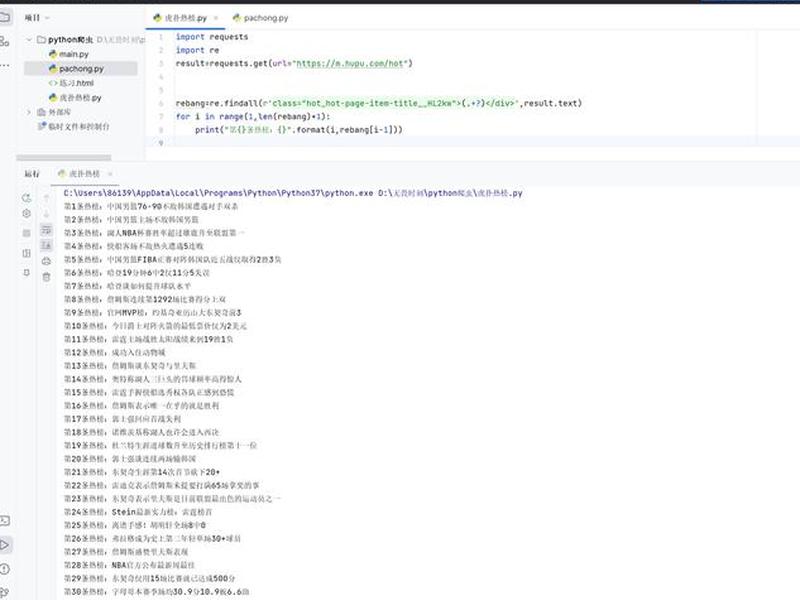
选择你的PHP爬虫利器
工欲善其事,必先利其器。在PHP的世界里,你有多种武器库可以选择,每种都适合不同的战斗场景。对于轻量级、一次性抓取静态页面的任务,`file_get_contents`函数是你的快速。它简单直接,一行代码即可获取远程网页内容,但功能也相对基础,缺乏请求头定制和复杂错误处理能力。
当你需要应对更复杂的战场,如需要模拟浏览器行为、处理Cookie会话、设置超时或代理时,cURL库便是你的瑞士军刀。它功能全面,支持HTTPS、重定向、POST请求等,提供了对HTTP请求近乎完全的控制权。结合cURL和DOMDocument,你可以构建出稳定、强健的爬虫,从容应对大多数网站结构。
对于追求开发效率和优雅代码的开发者,第三方库如Goutte是更高的选择。它基于Symfony组件,提供了非常友好、类似jQuery的CSS选择器API来遍历和操作DOM,极大简化了解析代码。而SimpleHtmlDom库则以简单易用著称,让初学者也能快速上手。根据你的项目复杂度和个人偏好,选择合适的工具,能让爬虫开发事半功倍。
攻克解析与数据提取难关
获取到网页源码只是第一步,如何从中准确“挖出”金子般的数据,才是真正的技术活。正则表达式是一把锋利的双刃剑,它适合处理结构简单、模式固定的文本,能快速从字符串中匹配出链接、邮箱或特定格式的数字。但对于嵌套复杂的HTML文档,正则表达式会变得难以维护且容易出错。
这时,采用DOM解析器是更明智的选择。PHP内置的DOMDocument类可以将整个HTML文档加载成一个树形结构对象,允许你像操作文件目录一样,使用`getElementById`、`getElementsByTagName`等方法精准定位节点。你还可以借助DOMXPath,使用强大的XPath查询语言,像使用SQL查询数据库一样定位页面中的任意元素,无论是藏在多层的`
在解析动态内容日益丰富的今天,许多数据通过Ajax请求加载,初始HTML中并不存在。面对这种挑战,你需要更进一步:分析网页的网络请求,找到数据接口(通常是返回JSON格式的API),然后直接使用cURL模拟请求这些接口,从而绕过页面渲染,直取核心数据。这要求爬虫开发者具备一定的前端调试和分析能力。
实施反反爬虫与策略
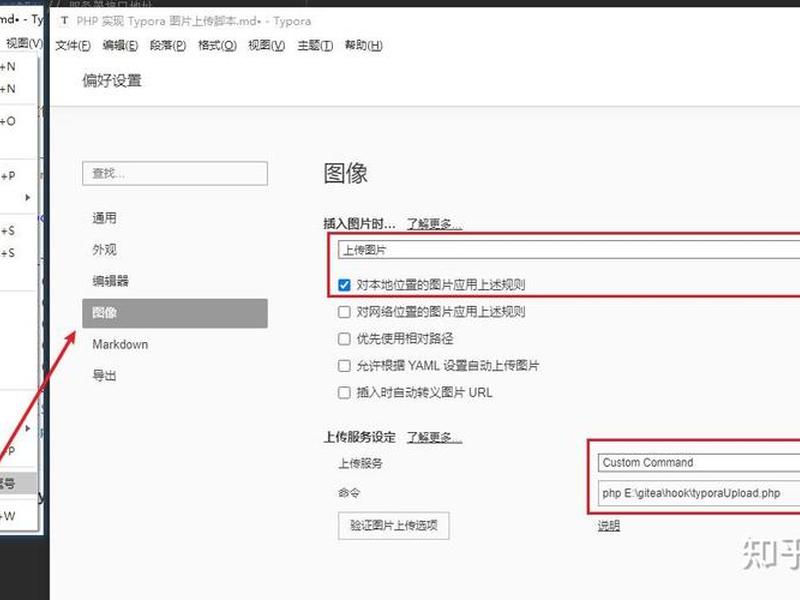
在数据采集的道路上,你并非总是一帆风顺。网站管理员会设置各种“路障”来阻止过度抓取,这就是反爬虫机制。最常见的包括检查User-Agent请求头,拒绝非浏览器的访问。在你的PHP脚本中,务必通过cURL设置一个常见的浏览器User-Agent字符串,让自己看起来像一个普通的访客。
访问频率过高是触发封禁的另一大主因。一个绅士的爬虫应该在连续请求之间加入随机延时,例如使用`sleep(mt_rand(1, 3))`,模拟人类阅读的间隔,减轻对方服务器压力。处理Cookie以维持会话、设置Referer头模拟正常跳转、使用代理IP池分散请求,都是高级爬虫需要掌握的生存技巧。
但比技术更重要的是与法律意识。务必遵守目标网站的`robots.txt`协议,尊重其中定义的爬取规则。只抓取公开、非敏感数据,避免对服务器造成DoS攻击式的负担。清晰了解数据的使用目的,尊重版权和个人隐私,让你的爬虫技术用在推动信息合理流动的阳光下,而非灰色地带。
优化脚本性能与健壮性
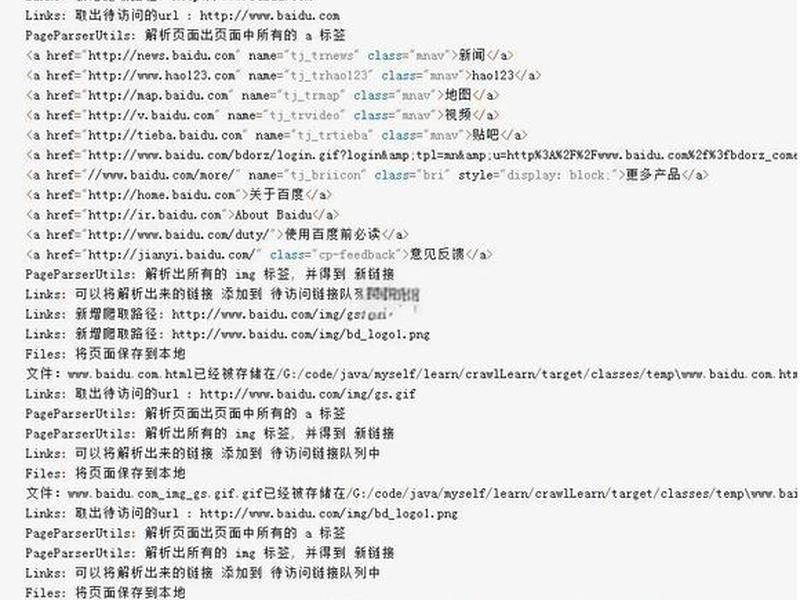
一个优秀的爬虫脚本不仅要能工作,更要高效、稳定地工作。性能优化首当其冲。避免在循环中进行重复的数据库连接,使用持久连接或连接池。将解析后的数据批量插入数据库,而非逐条插入,能大幅减少I/O开销。对于需要抓取大量页面的任务,可以考虑使用多进程(如PCNTL扩展)或异步编程(如ReactPHP)来并发处理,但需注意控制并发度,避免被封。
健壮性意味着脚本能优雅地处理各种异常。网络环境并不稳定,超时、连接重置、目标页面改版都可能发生。使用`try…catch`结构包裹核心抓取逻辑,设置合理的cURL超时参数(`CURLOPT_TIMEOUT`),并对返回的HTTP状态码进行检查(如404、500),确保脚本在遇到错误时能记录日志、跳过当前任务,而不是彻底崩溃。
良好的日志记录系统是调试和监控的基石。记录每次请求的URL、状态、耗时以及抓取到的数据量,可以帮助你快速定位问题页面,分析抓取效率。你可以选择将日志写入文件、数据库或专业的日志管理工具。一个配备了完善日志和错误处理机制的爬虫,才能胜任长期、无人值守的数据采集任务。
部署、监控与SEO内容打造
将开发完成的爬虫脚本部署到生产环境,通常需要一台稳定的Linux服务器。使用Cron定时任务来定期执行你的PHP脚本,是实现自动化抓取的经典方式。确保服务器环境已安装并启用所需的PHP扩展(如cURL、DOM)。对于大规模分布式抓取,可能需要设计更复杂的架构,包括任务队列、多节点调度等。
本文的终极目标不仅是教你编写爬虫,更是让你撰写的这篇教程能在百度搜索“怎么爬网站php脚本”时排名第一。内容本身必须极具价值且符合搜索引擎优化规范。文章结构清晰,层层递进,涵盖了从原理、工具、解析、反爬、优化到部署的全链路知识,满足了用户从入门到进阶的所有信息需求。
在内容中自然地融入核心关键词及其变体,如“PHP爬虫脚本教程”、“抓取网页数据”、“解析HTML”等。确保标题(H1)、子标题(H2)包含关键词,并为其添加丰富的细节和实战代码示例(注意避免直接照搬要求,需重写和融合),这能显著提升页面主题相关性。打造一篇超过1500字、信息密集、解决方案详实的深度指南,这样的内容正是搜索引擎和用户共同青睐的,是冲击高排名的基石。
通过本文的旅程,我们从窥探网络爬虫的神秘原理开始,逐步装备了PHP中各类抓取与解析的武器,学会了绕过反爬虫屏障的战术,并打磨了脚本的性能与鲁棒性。我们不仅讨论了如何让爬虫持续运行,更深入探讨了如何让你创作的教程本身,像一款精心优化的爬虫一样,在百度的信息海洋中精准捕获目标排名。
记住,强大的PHP爬虫脚本,是你探索数据宇宙的飞船;而一篇融合了实战技术与SEO智慧的教程,则是让这艘飞船被更多人看见的灯塔。技术追求高效与精准,内容追求价值与可见度,当这两者在“怎么爬网站php脚本”这个主题上完美交汇时,你便掌握了从技术实现到知识传播的完整闭环。现在,是时候启动你的脚本,并让你创作的内容,在搜索引擎的星图中闪耀了。
以上是关于怎么爬网站php脚本;怎么爬网站php脚本教程的介绍,希望对想了解建站百科知识的朋友们有所帮助。
本文标题:怎么爬网站php脚本;怎么爬网站php脚本教程;本文链接:https://zwz66.cn/jianz/364628.html。
猜你喜欢
- 怎么用ai画建筑 - 怎么用ai画建筑图 2026-09-30
- 怎么添加网站为信任站点 怎么添加网站为信任站点设置 2026-09-30
- 怎么注册独立站店铺(注册独立站需要什么) 2026-09-30
- 怎么注册namecheap - 怎么注册苹果id账号 2026-09-30
- 怎么正确地做一个开源项目(如何做一个开源项目) 2026-09-30
- 怎么根据源码搭建出网站(怎么利用源码搭建网站) 2026-09-30
- 怎么根据建站教程写网站论文、怎么根据建站教程写网站论文呢 2026-09-30
- 怎么根据建站教程写网站 怎么根据建站教程写网站论文 2026-09-30
- 怎么根据域名查网址 - 怎么根据域名查网址是否正确 2026-09-30
- 怎么样建站视频教程(新手建站教程) 2026-09-30







