怎么复制一个网站全部源码 怎么复制一个网站全部源码文件
-
怎么,复制,一个,网站,全部,源码,文件,在,

- 建站百科知识-小虎建站百科知识网
- 2026-09-30 11:36
- 小虎建站百科知识网
怎么复制一个网站全部源码 怎么复制一个网站全部源码文件 ,对于想了解建站百科知识的朋友们来说,怎么复制一个网站全部源码 怎么复制一个网站全部源码文件是一个非常想了解的问题,下面小编就带领大家看看这个问题。
在互联网的浩瀚海洋中,你是否曾被某个网站的精美设计或巧妙功能所吸引,渴望一探其背后的代码奥秘?无论是为了学习借鉴、进行数据分析,还是为了保存珍贵的网页资料,掌握复制一个网站全部源码文件的方法,无疑是打开这扇神秘之门的钥匙。本文将深入浅出,为你揭示从简单到专业、从静态到动态的各种核心方法,让你不仅能获取网页的HTML骨架,更能捕获其完整的“数字基因”——包括CSS样式、JavaScript脚本乃至图片资源,实现真正意义上的网站源码全复制。
一、浏览器内置:最快捷的入门之道
对于大多数静态网页而言,最直接的方法就隐藏在浏览器之中。无需安装任何额外工具,利用浏览器的“查看页面源代码”功能,即可迅速获取网页加载时的原始HTML代码。只需在目标网页右键点击,选择相应选项,或直接使用快捷键Ctrl+U,一个包含所有基础HTML结构的窗口便会呈现眼前。
这种方法获取的仅是服务器最初响应的“静态快照”。现代网站大量依赖JavaScript动态渲染内容,这些后续生成的部分往往无法通过查看源代码获得。浏览器的“开发者工具”便成为更强大的武器。按下F12键,在“Elements”(元素)面板中,你可以看到浏览器实时渲染后的完整DOM树。右键点击顶层的``标签,选择“Edit as HTML”或“复制”->“复制 outerHTML”,便能捕获此刻页面上的所有HTML代码。更进一步,若想保存整个网页为本地文件,包括其中的图片和样式表,可以使用“另存为”功能。在浏览器菜单中选择“另存网页为”,并将保存类型设置为“网页,完整”,浏览器便会自动下载HTML文件并创建一个关联文件夹,存放页面所需的全部资源。这是初学者理解网页构成最直观的途径。
二、命令行利器:高效批量抓取术
如果你追求效率,或者需要处理大量网页,命令行工具是你的不二之选。对于Linux或macOS用户,`wget`和`curl`是两位久经沙场的老兵。只需一行简单的命令,如`wget -p -k https://example.com`,即可将目标网页及其所有依赖资源递归下载到本地,自动转换链接以适应离线浏览。
Windows用户同样可以通过安装GNU Win32版本的wget或使用PowerShell的相关命令来实现类似功能。这些工具的强大之处在于其可脚本化,你可以编写简单的批处理脚本,自动遍历并抓取整个网站的目录结构,非常适合进行网站备份或镜像。它们直接从服务器请求资源,速度快且直接。
但命令行工具的局限性在于,它们通常无法执行JavaScript。对于高度依赖前端框架(如React、Vue.js)渲染的现代单页应用,直接使用wget抓取到的可能只是一个近乎空白的HTML外壳,因为核心内容需要JS执行后才能生成。此方法更适用于传统架构或纯静态网站。
三、Python爬虫:灵活定制的编程艺术
当需要对抓取过程进行精细控制时,Python凭借其丰富的库生态成为首选。使用`requests`库可以轻松发起HTTP请求,获取网页的HTML响应。将获取的文本内容写入本地文件,一个基本的静态网页抓取器就完成了。这种方法让你能自定义请求头,模拟真实浏览器访问,以规避一些简单的反爬机制。
面对动态内容,`requests`同样力不从心。这时,就需要请出自动化测试的王者——`Selenium`。Selenium可以驱动真实的浏览器(如Chrome、Firefox)运行,等待页面完全加载、JavaScript执行完毕,再通过`driver.page_source`属性获取完整的、渲染后的HTML源码。你甚至可以模拟点击、滚动等交互操作,以触发和抓取懒加载的内容。
结合`BeautifulSoup`或`lxml`进行HTML解析,你可以精准提取所需的特定部分;再配合`os`和`shutil`库,便能将页面链接的CSS、JS、图片等资源一并下载并组织好目录结构。虽然设置稍显复杂,但Python方案提供了无与伦比的灵活性与强大功能,是技术开发者复制复杂网站源码的终极利器。
四、浏览器插件:小白用户的福音
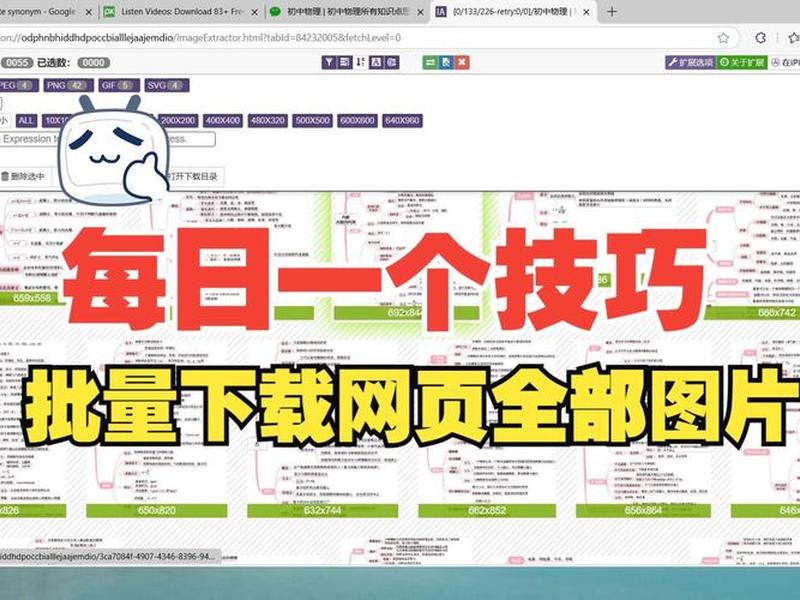
如果你并非开发者,但又需要稳定、便捷地获取完整源码,各类浏览器扩展插件是你的绝佳帮手。例如,“Save All Resources”这类插件,安装后只需按下F12打开开发者工具,在相应的插件面板点击一个按钮,即可将当前标签页所有加载的资源(HTML、CSS、JS、字体、图片等)一键打包下载到本地。
这类插件的工作原理是拦截并保存浏览器网络请求中获得的所有文件。它们操作可视化,几乎无需学习成本,就能获得一个可用于离线浏览的完整网页副本。对于需要分析网站资源构成、学习前端技术或简单保存网页的用户来说,这种方法既高效又可靠。
值得注意的是,插件的效果取决于页面资源的加载方式。对于某些通过复杂用户交互才加载的内容,可能仍需手动触发。选择插件时应注意其安全性和更新维护情况,避免使用来路不明的扩展,以防隐私泄露。
五、应对限制:破解复制壁垒的巧思
在复制源码的实践中,你可能会遇到各种限制:网页禁止右键、禁止复制、内容需登录或开通VIP才能查看。别担心,这些壁垒大多有法可破。最经典的思路是“打印预览”法。在目标网页按下Ctrl+P,进入打印预览模式,大部分针对网页的复制限制在此界面会失效,你可以直接选择并复制文本内容。
另一种思路是直接查看“源代码”。即便网页禁止右键,通常仍可通过浏览器菜单栏的“开发者工具”选项或快捷键Ctrl+U打开源代码视图。在这里,所有文本内容都以代码形式存在,你可以通过搜索(Ctrl+F)关键词,定位并复制所需部分。虽然夹杂HTML标签,但通过文本编辑器的查找替换功能可以快速清理。
更进阶的方法是使用控制台指令。打开开发者工具的Console(控制台)面板,输入特定的JavaScript命令(如`document.body.innerText`或针对特定容器的选择器),可以直接提取出页面的纯文本内容。这种方法需要一点技术知识,但能绕过绝大多数前端脚本设置的复制障碍。
六、从源码到资源:获取完整文件体系
真正的“复制全部源码文件”,远不止一个HTML文档。一个现代网站是由HTML、CSS、JavaScript、图像、字体等多种文件共同构成的生态系统。在获取HTML后,还需关注这些外部资源。开发者工具的“Network”(网络)面板记录了页面加载的所有请求,你可以在这里逐一查看并保存每个资源文件。
对于系统性地下载整个站点的资源,可以考虑使用专业的网站抓取软件,如HTTrack或SiteSucker。这些工具能像搜索引擎蜘蛛一样,根据你设置的深度和规则,遍历整个网站的链接,将遇到的每一个页面和其关联资源都下载到本地,形成一个完整的、可离线浏览的网站镜像。
在整合这些资源时,务必注意相对路径与绝对路径的问题。本地化后的文件,其内部的资源引用路径可能需要相应调整,才能确保图片正常显示、样式正确加载。这个过程虽然繁琐,但却是真正理解和“拥有”一个网站前端代码的必经之路,让你能从整体架构视角审视其设计精髓。
以上是关于怎么复制一个网站全部源码 怎么复制一个网站全部源码文件的介绍,希望对想了解建站百科知识的朋友们有所帮助。
本文标题:怎么复制一个网站全部源码 怎么复制一个网站全部源码文件;本文链接:https://zwz66.cn/jianz/364345.html。
猜你喜欢
- 怎么学建站和seo优化,怎样seo建站 2026-09-30
- 怎么在阿里云建数据库 阿里云数据库建在哪里 2026-09-30
- 怎么在阿里云上搭建网络 - 怎么用阿里云建网站 2026-09-30
- 怎么在迷你世界里面搭建,怎么在迷你世界里面搭建建筑 2026-09-30
- 怎么在迷你世界里建,怎么在迷你世界里建房子 2026-09-30
- 怎么在迷你世界建一个漂亮的房子,怎么在迷你世界建一个漂亮的房子教程 2026-09-30
- 怎么在自己电脑上搭建网站;怎么在自己电脑上搭建网站软件 2026-09-30
- 怎么在腾讯做广告 - 怎么在腾讯做广告赚钱 2026-09-30
- 怎么在腾讯云服务器上搭建网站 怎么在腾讯云服务器上搭建网站呢 2026-09-30
- 怎么在百度云建立文件夹,百度云盘怎么建立文件 2026-09-30







