如何搭建大数据集群,如何搭建大数据集群平台
-
如何,搭,建大,数据,集群,平台,在,数据,爆炸,

- 建站百科知识-小虎建站百科知识网
- 2026-09-26 22:36
- 小虎建站百科知识网
如何搭建大数据集群,如何搭建大数据集群平台 ,对于想了解建站百科知识的朋友们来说,如何搭建大数据集群,如何搭建大数据集群平台是一个非常想了解的问题,下面小编就带领大家看看这个问题。
在数据爆炸的时代,企业手中堆积如山的销售记录、用户轨迹、生产日志,不再是冰冷的数字,而是亟待唤醒的“沉睡金矿”。数据散落各处、格式杂乱、处理缓慢,让这座金矿可望而不可及。构建一个强大、高效的大数据集群平台,便成为打通数据血脉、释放数据价值的核心引擎。它不仅是一个技术系统,更是企业迈向数据驱动决策的战略基石。本文将深入剖析搭建大数据集群与平台的完整路径,为您揭开从硬件选型到架构落地的神秘面纱。
规划先行:明确目标与架构选型
搭建大数据平台绝非简单的软件堆砌,而是一场始于清晰蓝图的战略工程。首要任务是明确业务目标:是为了实现海量日志的实时分析,还是要构建客户360度画像?不同的目标直接决定了技术架构的选型。
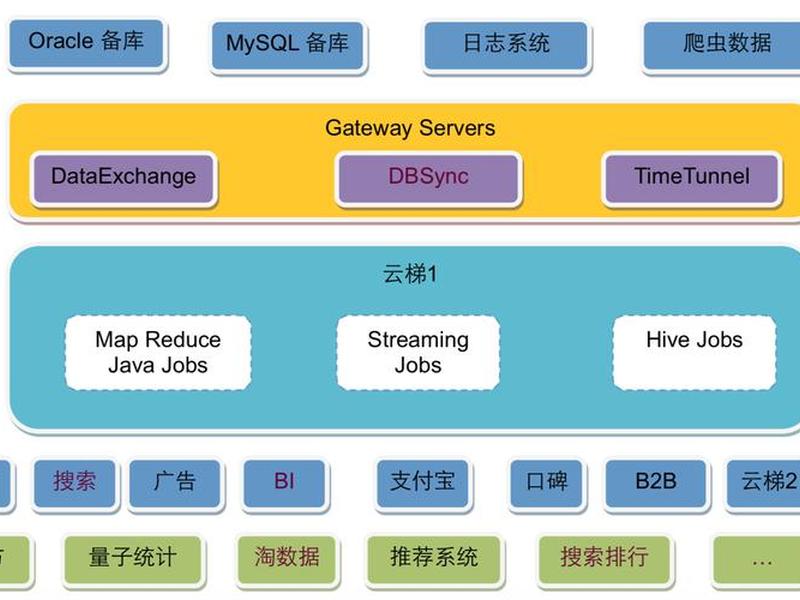
当前主流的大数据架构各有千秋。传统的Lambda架构兼顾离线批处理与实时流计算,稳定性高但存在逻辑冗余;更激进的Kappa架构统一以流处理为核心,通过数据重播处理历史任务,架构简洁但对技术能力要求极高。对于大多数企业而言,从实际业务复杂度出发,选择一种能够平衡实时性与准确性、并具备良好扩展性的架构是成功的第一步。
这一阶段还需考量未来与机器学习、人工智能平台的融合可能性。一个具有前瞻性的规划,能为企业的数据能力进化预留足够空间,避免陷入后期推倒重来的技术债务困境。
基石构建:硬件环境与集群部署
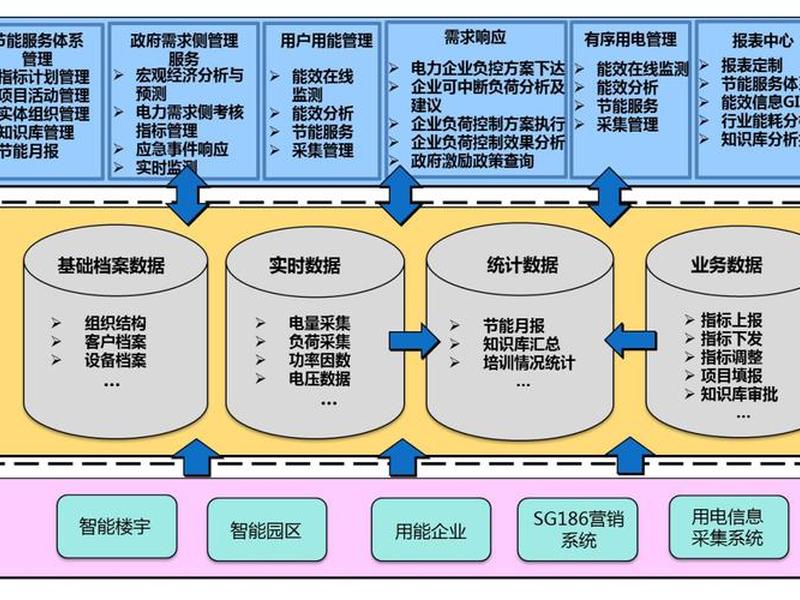
坚实的物理基础是集群稳定运行的保障。硬件规划需围绕数据规模与计算强度展开。核心原则是区分节点角色进行差异化配置:承担全局调度和元数据管理的NameNode与ResourceManager所在主节点,需要更强大的CPU和内存;而负责存储与计算的DataNode和NodeManager工作节点,则应配置大容量存储和均衡的计算资源。
部署模式上,生产环境通常采用完全分布式集群。这至少需要三立服务器:分别部署NameNode、SecondaryNameNode(作为元数据备份)和DataNode。建议将记录作业历史的History Server部署在第四台服务器上,以实现更好的隔离与性能。部署过程涉及操作系统配置、Java环境搭建、SSH免密互通等基础准备,确保各节点间能够顺畅通信。
随后是Hadoop核心组件——HDFS(分布式文件系统)与YARN(资源调度系统)的安装与配置。关键的配置文件如`core-site.xml`、`hdfs-site.xml`、`yarn-site.xml`需要根据集群网络、目录规划进行细致调整,例如正确配置DataNode的数据存储多目录,以充分利用多块磁盘性能。
核心配置:关键参数调优实战
默认配置往往无法发挥集群最佳性能,精细化的参数调优是挖掘平台潜力的关键。调优需从多个维度入手。在HDFS层面,需要根据集群规模调整NameNode处理RPC请求的线程数(`dfs.namenode.handler.count`),以应对高并发访问;合理设置数据块大小与副本因子,平衡存储效率与可靠性。
在YARN资源管理层面,必须根据服务器实际物理资源,正确设置`yarn.nodemanager.resource.memory-mb`和`yarn.nodemanager.resource.cpu-vcores`,防止资源分配过量或不足。对于MapReduce任务,则需要分别设定Map和Reduce任务的内存参数(`mapreduce.map.memory.mb`, `mapreduce.reduce.memory.mb`),以避免任务因内存溢出而失败。
启用合理的压缩机制(如Snappy、LZ4)可以有效减少磁盘I/O和网络传输压力;根据数据倾斜情况,调整`hive.groupby.skewindata`等参数以优化计算负载均衡。每一次调优都像是为引擎寻找最佳燃烧比,目标是让数据流在集群内高效、平稳地运转。
数据血脉:集成、处理与治理
平台搭建完成后,让数据流动起来才是价值所在。这需要构建完整的数据采集与集成链路。针对不同来源,采用不同工具:使用Sqoop从传统关系数据库进行批量迁移,利用Flume收集实时日志流,通过Kafka构建高吞吐量的消息队列以解耦生产与消费,对于互联网数据则可引入爬虫框架。
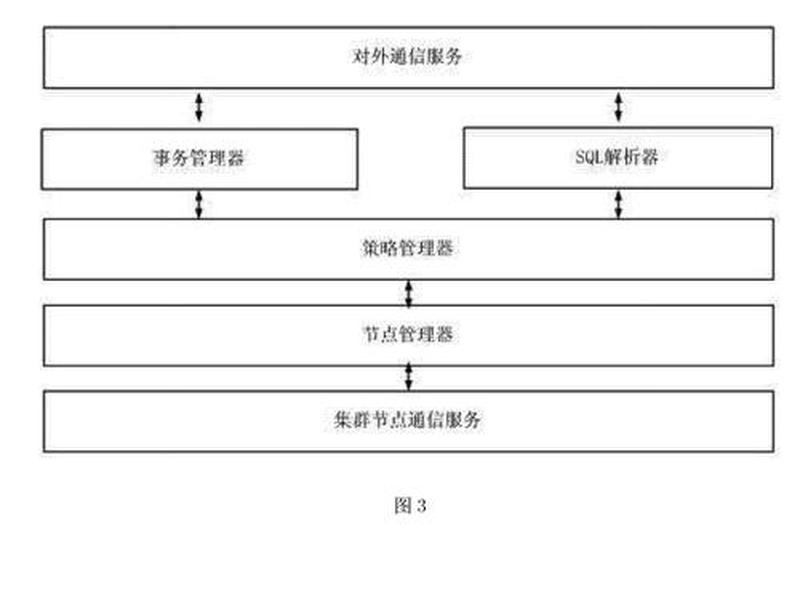
数据进入平台后,便进入处理与加工阶段。依托Hive、Spark SQL等进行离线批处理,完成数据清洗、转换与聚合;利用Flink、Spark Streaming等框架处理实时流数据,实现即时监控与业务反馈。这一层是原始数据转化为信息知识的核心车间。
必须建立数据治理体系,包括元数据管理、数据质量监控、血缘追踪和权限控制。没有治理的数据湖终将沦为数据沼泽。统一的标准和规范能确保数据口径一致、质量可靠、使用安全,让所有分析师和业务部门都能基于可信的数据开展工作。
高可用与扩展:保障持续稳定运行
对于生产系统,高可用性是不容妥协的要求。需要为HDFS NameNode和YARN ResourceManager配置高可用方案,通常借助ZooKeeper实现故障自动切换,避免单点故障导致整个集群瘫痪。JournalNode用于共享编辑日志,确保主备NameNode元数据的一致性。
随着业务增长,数据量和计算需求必然膨胀,平台的弹性扩展能力至关重要。Hadoop分布式架构的优势在此显现:可以通过横向增加DataNode和NodeManager节点来线性扩展存储与计算能力。新增节点后,需使用`start-balancer.sh`工具执行数据均衡操作,使数据均匀分布 across 所有节点,避免出现“热点”。
日常运维还需建立完善的监控告警体系,对集群健康度、资源利用率、任务执行状态等进行全方位监控。定期巡检和性能瓶颈分析,能够帮助运维团队提前发现问题,确保这个复杂的数据帝国7x24小时稳定运转。
生态融合与平台升华
一个孤立的大数据集群价值有限,唯有融入更广阔的生态才能最大化其效能。可以在核心存储计算层之上,引入OLAP分析引擎(如Presto、Kylin)以支撑亚秒级即席查询;搭建机器学习平台(如MLlib、TensorFlow on Spark)挖掘深度数据价值;通过数据可视化工具将分析结果转化为直观图表和报表。
最终,大数据平台应向上支撑丰富的业务应用场景,如精准营销、风险控制、供应链优化和用户画像等。它从底层的技术架构,演变为驱动业务创新的核心中枢。平台的建设也从一次性项目,转变为持续迭代、伴随业务共同成长的有机生命体。
搭建大数据集群平台是一场融合了技术深度与战略广度的旅程。它始于清晰的业务洞察与架构规划,成于扎实的硬件部署与精细调优,兴于流畅的数据管道与严格治理,最终升华于稳定的服务能力与广阔的生态融合。这座数据大厦的每一块砖瓦都至关重要,从规划到运维的每一步都需严谨细致。当数据开始在这座精心构建的平台上自由流动、碰撞、产生智慧时,企业便真正拥有了在数字时代决胜未来的核心资本。
以上是关于如何搭建大数据集群,如何搭建大数据集群平台的介绍,希望对想了解建站百科知识的朋友们有所帮助。
本文标题:如何搭建大数据集群,如何搭建大数据集群平台;本文链接:https://zwz66.cn/jianz/360401.html。
猜你喜欢
- 如何搭建宝塔、如何搭建宝塔面板 2026-09-26
- 如何搭建外贸销售平台、如何搭建外贸销售平台的方法 2026-09-26
- 如何搭建外贸网站、如何搭建外贸网站和网站 2026-09-26
- 如何搭建外网可以访问的服务器 如何搭建外网可以访问的服务器地址 2026-09-26
- 如何搭建外网ip - 如何搭建外网环境访问gemini 2026-09-26
- 如何搭建域名解析服务器(如何搭建域名解析服务器网络) 2026-09-26
- 如何搭建域名、如何搭建域名ip 2026-09-26
- 如何搭建垂钓台视频 - 如何搭建垂钓台视频讲解 2026-09-26
- 如何搭建商城网站;如何搭建商城网站平台 2026-09-26
- 如何搭建商业中心(如何搭建商业中心英语作文) 2026-09-26







