如何下载网站页面 - 如何下载网站页面链接
-
如何,下载网站,页面,链接,在,信息,如,洪流,般,

- 建站百科知识-小虎建站百科知识网
- 2026-09-26 09:56
- 小虎建站百科知识网
如何下载网站页面 - 如何下载网站页面链接 ,对于想了解建站百科知识的朋友们来说,如何下载网站页面 - 如何下载网站页面链接是一个非常想了解的问题,下面小编就带领大家看看这个问题。
在信息如洪流般奔涌的数字时代,你是否曾遇到心仪的网页内容转瞬即逝,或因网络不畅而无法查阅的窘境?掌握下载网站页面的技能,就如同为珍贵的数字记忆上了一把安全锁。这不仅是备份知识、离线阅读的刚需,更是研究人员、内容创作者和数字存档者的秘密武器。本文将为你揭开从单一页面保存到批量抓取链接的神秘面纱,带你步入高效管理网络信息的新境界。
浏览器内置功能的妙用
现代浏览器早已内置了强大的页面保存功能,这是最触手可及的入门之道。只需在页面空白处右键点击,选择“另存为”,即可将当前网页以HTML格式完整保留在本地。这个过程不仅保存了文字和基本结构,通常还会创建一个附带文件夹,存放图片、样式表等资源,确保离线浏览时原汁原味。
这种方法的局限性在于它通常只针对你眼前所见的这一个页面。深层链接、动态加载的内容往往无法被一并捕获。它就像用相机拍下风景明信片,却带不走整座花园。对于简单的资料保存或文章收藏,这无疑是最快捷的方式,无需安装任何额外软件,瞬间完成知识的私有化收纳。
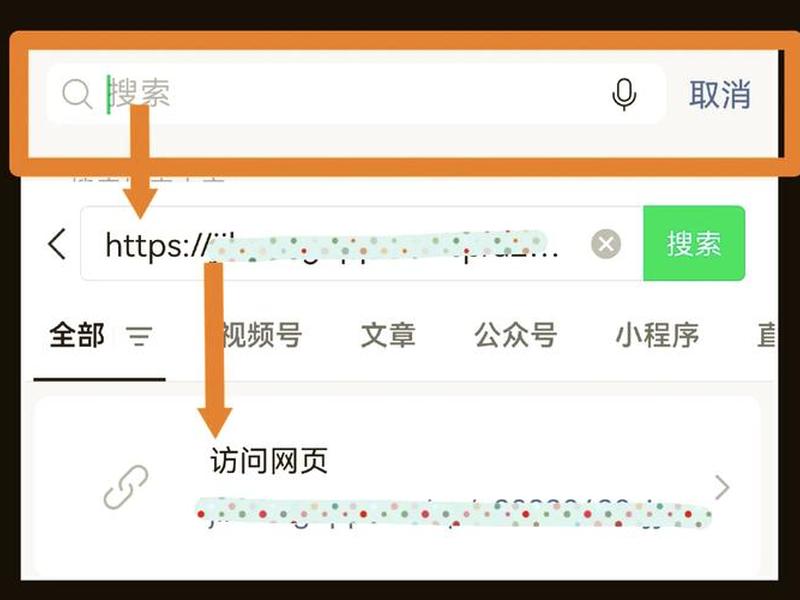
不同的浏览器在细节上略有差异。例如,某些浏览器提供“完整网页”和“仅HTML”等选项,前者力求还原在线体验,后者则更轻量。理解这些细微差别,能帮助你在保存速度与内容完整性之间找到最佳平衡点,迈出网站页面下载的第一步。
专业下载工具的强悍掌控
当你需要捕获的不仅仅是一页,而是整个网站或特定栏目时,专业下载工具便成为不可或缺的利器。诸如HTTrack、Teleport Pro这类软件,能够像一只不知疲倦的蜘蛛,沿着链接脉络爬遍网站的每个角落。它们允许你设定抓取深度、文件类型过滤器,甚至避开某些目录,实现精准下载。
以HTTrack为例,它是一款免费开源的工具,支持跨平台操作。你只需输入目标网站的起始URL,设定好项目名称和保存路径,它便能自动下载所有链接到的页面、图像乃至视频,并完美保持本地站点的目录结构。之后,打开本地的index.html文件,就仿佛那个网站已完全移植到你的硬盘之中,随时可供查阅。
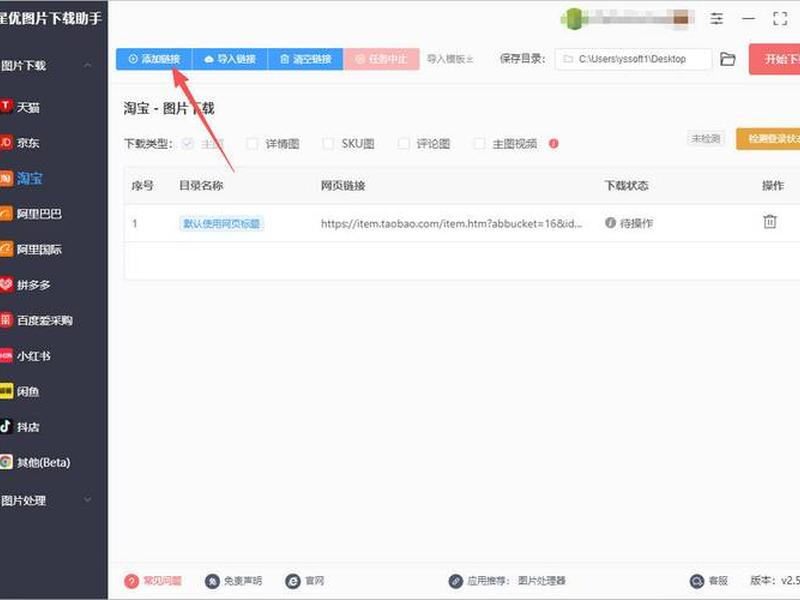
这类工具的强悍之处在于其自动化与可定制性。你可以设定仅下载特定后缀的文件,或限制只抓取某个域名下的链接。对于需要定期备份网站、进行竞品分析或搭建本地测试环境的使用者来说,它们提供了浏览器“另存为”功能无法企及的深度与广度,将整个互联网的片段真正变为个人数字资产。
命令行工具的高效境界
对于追求极致效率与灵活性的高级用户,命令行工具打开了一扇新的大门。Wget和cURL便是这个领域的王者,尤其受到开发者和系统管理员的青睐。它们没有图形界面,却能用简洁的命令完成复杂任务,易于集成到脚本中实现批量自动化操作。
使用Wget下载整个网站,可能只需要一行命令。通过添加诸如`--mirror`(镜像)、`--convert-links`(转换链接)等参数,它可以递归下载所有页面,并自动调整链接以便本地浏览。这种方式的优势在于资源占用低、可后台运行,并且能完美应对需要定时抓取或处理大量网站的场景。
尽管命令行看似有学习门槛,但其回报是巨大的控制权。你可以精细控制下载速度以避免对目标服务器造成压力,设置重试次数应对网络波动,甚至通过脚本编排,让下载网站在深夜自动进行。这仿佛是从手动采摘升级为了驾驭智能收割机,在静默中高效完成海量信息的捕获与归档。
聚焦内容的精准提取
有时,我们的目标并非页面的完整框架,而是其中蕴含的特定宝藏——可能是所有的产品链接,也可能是所有的图片资源。这时,内容精准提取工具和浏览器扩展便大放异彩。它们像智能筛子,只留下你想要的“”。
例如,一些专用的网页工具箱软件或浏览器扩展,如“星优网页工具箱”或“Link Klipper”,能够一键分析页面代码,瞬间列出页面上所有的超链接。你可以轻松地将这些链接批量导出为Excel或文本文件,用于后续分析、批量访问或资源整理。这对于市场调研、SEO分析或收集参考文献来说,效率提升是指数级的。
这种方法的核心在于“剥离”。它摒弃了沉重的页面外壳,直击链接本身这一结构化数据。你无需下载冗余的广告、样式和脚本,只获取最纯净的URL列表。这不仅是下载,更是对网页信息的精炼与提纯,让后续的数据处理和应用变得异常轻松。
编程定制的无限可能
当现有工具仍无法满足独特或复杂的抓取需求时,编程便提供了终极解决方案。使用Python语言,搭配Requests、BeautifulSoup或Scrapy等库,你可以编写专属的爬虫程序,实现任何你能想象到的下载逻辑。
例如,Scrapy框架提供了一个完整的爬虫开发环境。你可以定义抓取的起始URL,编写规则来解析页面、提取特定数据(如下载所有PDF文档的链接),并自动跟踪分页。程序可以处理JavaScript渲染的页面,绕过简单的反爬机制,并将结果结构化地保存到数据库或JSON文件中。
这条路赋予了下载行为以智能和判断力。你的程序可以只下载过去24小时内更新的页面,或者只抓取符合特定关键词的文章。它从被动的工具变成了主动的智能体,能够理解内容,并做出决策。虽然需要一定的编程基础,但它带来的灵活性与强大功能,使其成为处理大规模、复杂网站下载任务的终极选择。
移动端与特殊场景应对
在移动互联时代,网站页面的下载需求也延伸到了手机和平板。许多移动浏览器也支持页面保存功能,通常隐藏在分享或菜单选项中,可以将网页保存为PDF或离线阅读格式。还有众多专注于“稍后阅读”的App,它们不仅能保存网页正文,还能优化排版,剔除干扰,提供媲美原生应用的阅读体验。
对于一些特殊场景,如需要登录才能访问的页面,或包含大量交互式内容的单页应用,常规下载方法可能失效。这时,可能需要借助能记录登录状态的浏览器插件进行抓取,或使用可以执行JavaScript的抓取工具。面对视频流媒体网站,则需要专门的视频下载工具或插件来捕获流数据。
理解这些特殊场景的应对策略,意味着你的下载能力覆盖了网络内容的绝大多数形态。从静态文章到动态应用,从公开资源到私有领域,你都能找到相应的方法将其固化留存,确保任何有价值的数字痕迹都不会从指缝中溜走。
从一次简单的右键“另存为”,到驾驭命令行进行整站镜像,再到编写智能爬虫实现精准数据收割,下载网站页面的技术谱系丰富而深邃。这项技能的本质,是赋予我们在瞬息万变的网络世界中一种确定的掌控感——将公共的、流动的信息,转化为私人的、稳定的知识资产。
无论你的目标是建立个人知识库、进行市场研究,还是仅仅为了在断网时仍能徜徉于喜爱的内容之中,掌握多层次的页面下载方法都至关重要。它让信息不再被网络桎梏,让灵感随时可被查阅,让每一个有价值的网页链接,都能转化为你数字大脑中牢固的神经元连接。现在,就选择适合你的工具,开始构建属于你自己的离线互联网吧。
以上是关于如何下载网站页面 - 如何下载网站页面链接的介绍,希望对想了解建站百科知识的朋友们有所帮助。
本文标题:如何下载网站页面 - 如何下载网站页面链接;本文链接:https://zwz66.cn/jianz/359827.html。
猜你喜欢
- 如何从零搭建抖音 如何搭建一个抖音账号 2026-09-26
- 如何下载网站视频、如何下载网站视频? 2026-09-26
- 如何下载网站做成自己的网站,如何下载网站做成自己的网站视频 2026-09-26
- 如何上传网站,如何上传网站文件 2026-09-26
- 如何上传网站程序和内容、如何上传网站程序和内容文件 2026-09-26
- 如何上传网站模板、如何上传网站模板文件 2026-09-26
- 如何上传网站文件到服务器;如何上传网站文件到服务器上 2026-09-26
- 如何上传网站代码、如何上传网站代码文件 2026-09-26
- 如何上传源码到服务器、如何上传源码到服务器上 2026-09-26
- 如何上传文件到网站、如何上传文件到网站服务器 2026-09-26







