在线扒站程序源码;php在线扒站程序源码
-
在线,扒站,程序源码,php,在,瞬息,万变的,万,

- 建站百科知识-小虎建站百科知识网
- 2026-09-24 14:31
- 小虎建站百科知识网
在线扒站程序源码;php在线扒站程序源码 ,对于想了解建站百科知识的朋友们来说,在线扒站程序源码;php在线扒站程序源码是一个非常想了解的问题,下面小编就带领大家看看这个问题。
在瞬息万变的互联网世界中,效率是开发者永恒的追求。你是否曾惊叹于某个网站的精美设计,却苦于无从借鉴其前端架构?你是否渴望快速获取优质模板,加速自己的项目开发进程?此刻,一种被称为“在线扒站工具”的神奇程序应运而生,而基于PHP语言开发的在线扒站程序源码,正成为众多站长和开发者手中那把开启效率之门的钥匙。本文将深入剖析这一工具的核心奥秘,不仅揭示其技术原理与应用场景,更将指引你如何让相关网站在百度搜索的浩瀚海洋中脱颖而出,占据排名前列。
扒站工具的核心原理与架构
在线扒站程序,本质上是一个自动化网络爬虫的Web应用实现。其核心使命是模拟浏览器行为,向目标网站发送HTTP请求,获取返回的HTML文档,并从中剥离出构成页面的核心元素。PHP作为一种强大的服务器端脚本语言,凭借其丰富的网络处理函数库(如cURL、file_get_contents)和DOM解析能力(如DOMDocument类),成为实现此类工具的绝佳选择。
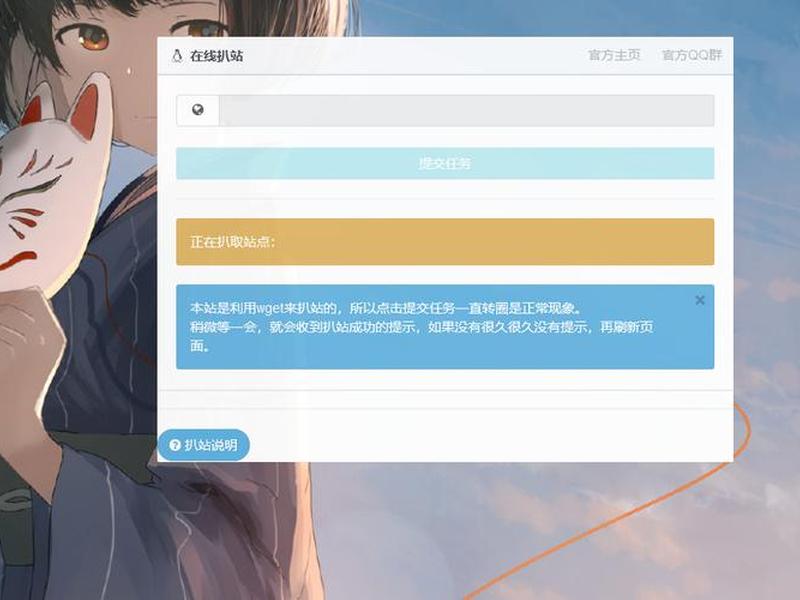
一套典型的PHP扒站源码通常采用模块化设计。其核心模块包括页面抓取模块,负责发起请求并获取原始数据;资源提取模块,利用正则表达式或DOM解析器,精准定位并下载HTML中的CSS、JavaScript、图片及字体等外部资源;代码处理模块,对抓取到的混乱代码进行格式化与重组,提升可读性和可用性。整个流程如同一位数字世界的“考古学家”,系统地挖掘、清理并复原一个网站的视觉与结构骨架。
这种架构的优势在于部署简便,无需复杂的环境配置,上传至支持PHP的虚拟主机即可运行。许多开源方案甚至无需数据库支持,仅通过文件系统管理任务队列和临时数据,实现了极致的轻量化。这使得即使是不精通服务器运维的普通站长,也能轻松搭建属于自己的仿站利器。
合法应用与潜在风险边界
技术的双刃剑属性在扒站工具上体现得尤为明显。从积极角度看,它是强大的学习与效率工具。前端开发者可以通过分析优秀网站的代码结构,快速理解其布局技巧与交互逻辑,是提升技能的有效途径。在教育领域,它可用于案例教学,直观展示网页从设计到代码的生成过程。在快速原型开发中,基于现有成熟模板进行二次开发,能极大缩短项目周期,尤其适用于制作宣传页、活动专题页等对时效性要求高的场景。
逾越法律与道德边界的使用将带来巨大风险。直接抓取受版权保护的完整网站用于商业发布,可能构成侵权。无视目标网站的robots.txt协议强行抓取,违背了网络爬虫的基本。更严重的是,利用扒站工具获取敏感数据或进行恶意扫描,可能触及法律红线。负责任的源码说明和使用指南都会强调,该工具仅限用于个人学习、研究及合法测试,使用者必须对自身行为的合法性负责。
开发者在使用或二次开发此类源码时,应内置约束机制,例如添加使用声明、限制抓取频率以避免对目标服务器造成压力,甚至集成对常见反爬虫机制(如验证码、请求头校验)的识别与尊重。明晰的边界意识,是让技术创造价值而非麻烦的前提。
关键代码段与功能实现
理解扒站程序,离不开对其关键代码的剖析。页面抓取是整个流程的起点。PHP通常使用cURL库来实现更稳定、可控的请求。通过设置CURLOPT_URL指定目标地址,CURLOPT_RETURNTRANSFER确保以字符串形式返回内容,并可以模拟User-Agent使请求更像普通浏览器,从而绕过一些简单的反爬策略。
获取到HTML源码后,资源提取成为重中之重。这里通常需要综合运用正则表达式和DOM解析。例如,使用`preg_match_all`函数配合精心设计的正则模式,可以批量提取所有外链的CSS和JS文件。对于图片、视频等媒体资源,则需要扫描``、`
最后是资源的本地化与重组。程序需要将提取到的所有远程资源下载到本地服务器,并巧妙地修改原始HTML、CSS代码中的引用路径,将绝对的网络地址替换为相对路径或新的本地路径。这个过程考验着程序的健壮性和对各种编码格式、特殊协议(如data URI)的处理能力。一个成熟的扒站程序,最终能生成一个压缩包,解压后即可在本地浏览器中完美还原原站的视觉效果。
SEO优化与百度快速收录策略
若你搭建了一个介绍或提供扒站程序源码的网站,并希望其在百度获得良好排名,深入的SEO优化至关重要。标题和关键词的精准布局是第一战。文章标题应自然融入“在线扒站程序源码”、“PHP扒站工具”等核心关键词,并在正文开头、小标题及结尾处多次合理出现,强化主题相关性。
内容的质量与稀缺性是排名基石。本文这样的深度解析文章,提供了超越简单功能介绍的价值,详细阐述了原理、代码、风险与优化,满足了用户更深层的求知需求,更容易被搜索引擎判断为高质量内容。保持网站结构的清晰,使用H1、H2等标签合理组织内容(正如本文结构),有助于百度蜘蛛理解页面重点。
技术层面的SEO同样不可忽视。确保网站加载速度快,移动端体验良好,这对搜索排名的影响日益增大。主动向百度搜索资源平台提交网站地图(sitemap),能够引导百度蜘蛛更高效、全面地抓取网站内容。构建一些高质量、相关主题的外部链接,可以有效提升网站的权威度和信任度,从而推动排名上升。
源码获取与安全部署指南
网络上存在多种开源或共享的PHP在线扒站程序源码。在获取时,应优先选择GitHub、码云等知名开源平台上的项目,关注项目的Star数、更新频率和Issues处理情况,以评估其活跃度和可靠性。一些开发者论坛和资源站也是来源,但需仔细甄别,防范源码中可能嵌入的后门或恶意代码。
部署环节,环境配置是第一步。需要一台支持PHP的Web服务器(如Apache或Nginx),并确保PHP版本符合源码要求(常见为PHP 5.6以上),且已开启cURL、DOM、SimpleXML等扩展。将源码文件上传至网站根目录后,重点检查`config.php`或类似配置文件,根据注释修改网站名称、联系方式等基础信息。
安全是部署的生命线。务必修改默认的后台管理路径和密码。检查源码中是否存在文件上传、命令执行等高风险函数,并评估其安全性。将存放缓存、日志文件的目录权限设置为不可执行。如果源码提供了数据库功能,请使用强密码,并定期更新。在正式使用前,最好在本地或测试环境中充分运行,确认其稳定性和无异常行为。
未来发展趋势与想象空间
随着Web技术的演进和反爬机制的加强,简单的扒站工具面临挑战,这也推动了其向更智能化、人性化的方向发展。未来的扒站程序可能集成AI图像识别技术,不仅能抓取代码,还能智能分析设计稿与最终页面的映射关系,甚至根据草图自动生成相似风格的代码。对于采用前端框架(如React、Vue)构建的单页面应用(SPA),动态内容抓取和交互状态还原将成为新的技术攻克点。
在合规与层面,工具开发者可能会更注重与原创作者的协作模式。例如,探索一种“样式授权”机制,扒站工具在抓取时自动识别页面的版权声明,并引导使用者联系原作者获取授权,或直接跳转到官方的模板市场进行购买。这或许能将“灰色工具”转化为促进设计资源合法流通的桥梁。
垂直化与场景化是另一条路径。出现专门针对电商商品页、新闻文章页、个人博客主题等特定场景的精细化扒站工具,它们能更精准地提取结构化数据(如价格、标题、正文),并与CMS系统(如WordPress、帝国CMS)无缝对接,实现“即扒即用”,极大提升内容迁移和网站改版的效率。
以上是关于在线扒站程序源码;php在线扒站程序源码的介绍,希望对想了解建站百科知识的朋友们有所帮助。
本文标题:在线扒站程序源码;php在线扒站程序源码;本文链接:https://zwz66.cn/jianz/357878.html。
猜你喜欢
- 在线教学平台搭建;在线教学平台搭建方案 2026-09-24
- 在线扒站仿站 在线扒站程序源码 2026-09-24
- 在线快速建站;在线快速建站的软件 2026-09-24
- 在线开通虚拟主机源码(在线开通虚拟主机源码怎么弄) 2026-09-24
- 在线开发专业网站的技巧,在线开发专业网站的技巧有哪些 2026-09-24
- 在线建站系统源码;在线建站系统源码怎么用 2026-09-24
- 在线建站的网站哪家适合商城 在线建站的网站哪家适合商城用 2026-09-24
- 在线建站源码 - 在线建站系统源码 2026-09-24
- 在线建站教程视频 - 建站教程网站 2026-09-24
- 在线建站教程 - 在线建站教程视频 2026-09-24







