云主机部署大模型 云主机部署大模型是什么
-
云,主机,部署,大模型,是什么,在,人工智能,

- 建站百科知识-小虎建站百科知识网
- 2026-09-19 12:17
- 小虎建站百科知识网
云主机部署大模型 云主机部署大模型是什么 ,对于想了解建站百科知识的朋友们来说,云主机部署大模型 云主机部署大模型是什么是一个非常想了解的问题,下面小编就带领大家看看这个问题。
在人工智能浪潮席卷全球的今天,“大模型”已成为科技领域最炙手可热的核心词汇。一个训练精良的模型若想从实验室走入现实,真正赋能千行百业,其关键一跃便在于“部署”。云主机部署大模型,正是实现这一跃迁的主流路径与核心引擎。它绝非简单的技术搬运,而是一场融合了弹性算力、工程化架构与商业智慧的深度变革。本文将带您深入探索云主机部署大模型的本质、优势与实践核心,揭开其如何成为企业拥抱智能时代的最优解。
本质解析:从模型到服务的华丽蜕变
云主机部署大模型,远不止是将模型文件上传至云端服务器那么简单。其本质,是一套完整的系统工程,旨在将训练好的、拥有海量参数的AI模型,通过云主机提供的计算、存储与网络资源,转化为稳定、高效、可扩展的在线推理服务。
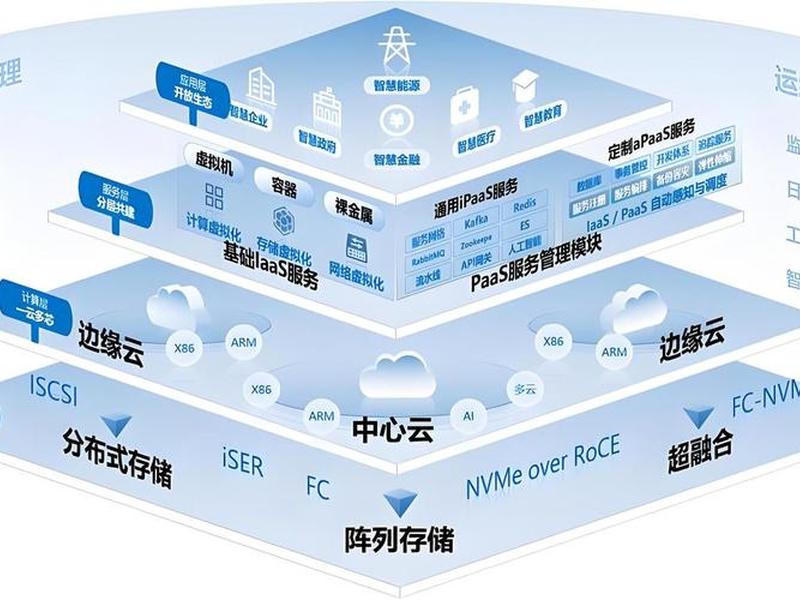
这标志着从“模型能力”到“业务价值”的关键转化。在云主机环境中,模型不再是孤立的文件,而是被封装成可通过API调用的标准化服务。它涉及模型适配、推理优化、服务封装、负载均衡、监控运维等一系列复杂环节,目标是确保服务能够以低延迟、高吞吐、高可用的状态,持续响应来自全球各地、不同场景的业务请求。云主机部署是模型价值释放的“最后一公里”,也是决定AI应用成败的临门一脚。
核心优势:云端赋能的四大魅力
为何选择云主机而非本地硬件?其魅力在于它完美契合了大模型应用的独特需求。首要优势是极致的弹性伸缩。大模型推理的算力需求并非恒定不变,在业务高峰时可能需要数十甚至上百张GPU并发,低谷时则只需基础资源。云主机可以像拧开水龙头一样,按需秒级获取或释放算力,企业无需为可能出现的峰值流量提前购置昂贵且易过时的硬件,实现了成本与效率的最优平衡。
其次是大幅降低的启动门槛与运维复杂度。自建GPU集群意味着高昂的初期投入、漫长的采购周期以及专业的运维团队。而云服务商提供了即开即用的高性能GPU实例、预置的优化环境与工具链,让开发者能够聚焦于业务逻辑与应用创新,而非底层设施维护。云平台集成的监控、日志、安全等服务,为企业提供了开箱即用的生产级保障。
再者是强大的生态集成与全球化服务能力。主流云平台不仅提供裸算力,更围绕大模型构建了从数据预处理、模型训练、精调、评估到部署、应用开发的全链路工具平台。企业可以便捷地调用各种配套服务,并轻松将AI服务部署到全球多个区域,确保终端用户获得低延迟的优质体验。
部署模式:公有云、私有云与混合之道
根据企业对数据安全、合规性及成本控制的不同要求,云主机部署主要衍生出三种主流模式。公有云部署是最常见的形式,企业直接租用阿里云、腾讯云、百度智能云等厂商的GPU云主机资源。这种方式灵活性最高,成本模式为按需付费,适合大多数对数据敏感性要求不高、追求快速上线和弹性扩展的业务场景,例如互联网公司的AIGC应用、智能客服等。
私有云部署则是在企业自建的数据中心或专有云环境中,搭建专属的GPU算力池来运行大模型。所有数据、模型和服务都在企业内网闭环,提供了最高级别的安全性与可控性,尤其符合金融、医疗、政务等强监管行业对数据隐私和合规的严苛要求。这需要企业具备相应的资金与技术实力进行一次性投入和长期运维。
而混合云部署巧妙地结合了二者之长。企业可以将非核心的、计算密集型的前端推理任务放在公有云上,以利用其无限的弹性;同时将涉及核心商业机密的数据处理与模型训练放在私有云中。这种模式在成本、安全与灵活性之间取得了精妙的平衡,正成为越来越多大型企业的首选架构。
关键技术栈:构建稳健服务的基石
一次成功的云主机部署,离不开一套成熟的技术栈支撑。在硬件层面,核心是选择与模型规模匹配的GPU实例。对于百亿参数以下的中等模型,NVIDIA的A10、V100或消费级的RTX 4090(显存24G)已能胜任;对于千亿级超大模型,则需要A100、H100等顶级计算卡,甚至多卡组成的集群。配套的高速SSD存储和低延迟网络(如InfiniBand)也是保障整体性能的关键。
在软件与框架层面,推理引擎是核心。TensorRT-LLM针对NVIDIA GPU做了极致优化,能显著降低延迟;vLLM则以其先进的内存管理和高吞吐特性闻名;ONNX Runtime提供了优秀的跨平台兼容性。服务框架如FastAPI、Triton Inference Server负责将模型能力封装成RESTful或gRPC接口。容器化技术(Docker)和编排工具(Kubernetes)实现了部署环境的标准化、隔离与自动化扩缩容,是云原生部署的标配。
模型优化是部署前的必修课。直接部署原始模型往往效率低下。通过量化技术(如将FP32权重转换为INT8或FP16),可以在几乎不损失精度的情况下,将模型体积压缩数倍,推理速度提升数倍,显存占用大幅降低。模型剪枝、知识蒸馏等技术也被用于进一步精简模型,使其更适配云主机的资源规格。
实践流程:从零到一的部署指南
一个标准的云主机部署流程,可以梳理为清晰的五步曲。第一步是环境准备与模型选型。根据业务场景(实时对话、批量处理)和预算,选择合适的云服务商、GPU实例规格以及模型(如7B、13B、70B参数版本)。同时完成云主机的系统初始化、驱动安装及基础依赖配置。
第二步是模型预处理与优化。将训练好的模型文件(如PyTorch的.pth格式)转换为适合生产环境部署的格式,如ONNX或引擎专属格式(如TensorRT的.plan)。并应用量化、图优化等技术,生成最终的部署模型。
第三步是服务封装与API暴露。使用选定的服务框架编写推理服务代码,加载优化后的模型,并定义输入输出接口。将整个应用及其依赖打包成Docker镜像,确保环境的一致性。
第四步是云端部署与配置。将Docker镜像推送至云主机的容器仓库,并通过Kubernetes或云服务商提供的托管服务进行部署。配置自动扩缩容策略、负载均衡器、域名解析以及SSL证书,使服务能够安全、稳定地对外提供。
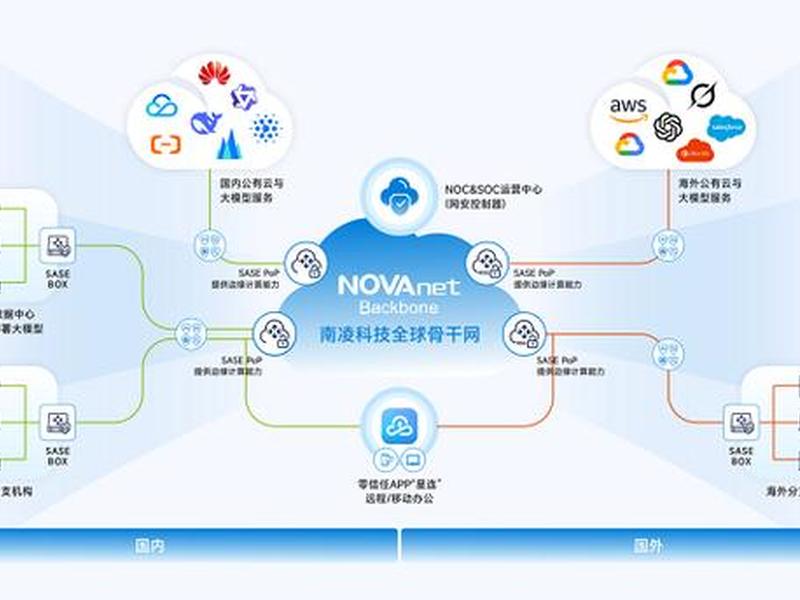
第五步是监控调优与持续迭代。部署上线并非终点。需要建立完善的监控体系,跟踪服务的响应延迟、吞吐量、错误率及资源利用率等关键指标。根据监控数据持续进行性能调优和成本优化,并建立模型的持续集成与持续部署(CI/CD)流水线,以支持模型的快速迭代与更新。
未来展望:云智融合的无限可能
展望未来,云主机部署大模型的技术边界与应用场景仍在不断拓展。一方面,Serverless(无服务器)架构正成为新趋势。开发者将无需管理任何服务器,只需提交模型和代码,云平台即可自动处理所有资源的分配、扩展和运维,实现更极致的敏捷与成本节约。
MaaS(模型即服务)生态日益繁荣。云厂商不仅提供裸算力,更直接提供经过精调优化的行业大模型API,企业可以像调用水电煤一样,按需调用最先进的模型能力,进一步降低AI应用的门槛。云边端协同部署模式也将成熟,在云端进行复杂训练和重型推理,在边缘设备进行实时轻量推理,形成立体化的智能算力网络。
以上是关于云主机部署大模型 云主机部署大模型是什么的介绍,希望对想了解建站百科知识的朋友们有所帮助。
本文标题:云主机部署大模型 云主机部署大模型是什么;本文链接:https://zwz66.cn/jianz/352256.html。
猜你喜欢
- 云主机部署网站、云主机部署网站是什么 2026-09-19
- 云主机适合学习建站吗 云主机适用于哪些网站 2026-09-19
- 云主机设置、云主机设置ipv6 2026-09-19
- 云主机解决方案 - 云主机解决方案有哪些 2026-09-19
- 云主机装系统怎么进入(云主机装系统怎么进入系统) 2026-09-19
- 云主机自制教程 云主机自制教程视频 2026-09-19
- 云主机能装windows 云主机能装openwrt吗 2026-09-19
- 云主机能不能看视频;云主机能不能看视频呢 2026-09-19
- 云主机网站源码 云主机网站源码是多少 2026-09-19
- 云主机终端搭建、云主机终端搭建软件 2026-09-19







